Yahoo!広告のデータを BigQuery に入れる|月次がレポートと合う3つの決めごと
Yahoo!広告のレポートには合計行や記号が混じることがあり、そのまま入れると合計が2倍になったり、取り直した日が二重になったりします。合計行・書式・同じ日の扱いを決め、控えた合計と突き合わせる手順です。
目次 クリックで開く
月が明けると、Yahoo!広告の管理画面から先月のレポートを書き出し、Google 広告の数字と一緒に見られるよう、社内のデータの置き場に取り込む。Google 広告は自動で入るようにしてあるので、Yahoo!広告も同じ形で並べればよいはずが、集計してみるとコストの合計が管理画面の倍近くある。何日か分を取り直した月は、その日だけ数字が膨らんでいる。どこでずれたのかを探しているうちに、月次の報告が後ろへずれていく。そんな月初はないでしょうか。
私たち Aurant Technologies は、広告の運用と、広告やアクセス解析のデータを1か所に集めて集計する仕組みづくりを支援している会社です。なお、Yahoo!広告は2026年4月1日から、LINE 広告とあわせて「LINEヤフー広告」になりました(LINEヤフー広告の公式サイト)。この記事では、なじみのある Yahoo!広告の名前で書きます。
書き出したレポートには、合計行や「–」のような記号が混じることがあります。API で取る場合は、既定で合計行が出力されます。そのまま取り込むと、合計行のぶんや、取り直した日の重なりのぶんだけ数字がずれます。入れる前に、合計行をどうするか、数字・日付・文字コードの書式、同じ日を二重に入れないこと、の3つを決め、その日の分を置き換える形で入れれば、取り込んだ表の合計は、書き出したレポートの合計と合います。月次の数字を、媒体のレポートと同じ数字で話せるようになります。
同じファイルを入れ方だけ変えて取り込んだとき、9月1〜14日のコストの合計がどれだけずれたかを図にしました。


点線に重なるのは、いちばん下の入れ方だけです。上の2つは、取り込みがエラーにならずに終わり、ずれたまま残ります。合計行のずれは、合計行がほかの行を足した値そのものなので、期間をどう取ってもちょうど2倍です。重なりのずれは、重なった日数とその日の金額で変わります。
決めたいのは、月次の数字を媒体のレポートと同じにすること
Yahoo!広告と Google 広告の数字を1つの表に並べるのは、月次の会議で、どの媒体のどのキャンペーンに予算を寄せるかを決めるためです。そのとき、取り込んだ表の数字が媒体のレポートと合っていないと、話は「どちらの数字が正しいのか」から始まってしまいます。月次の数字の定義と、良い・悪いの判定の作り方は広告の月次レポートの記事に書きました。この記事は、その手前の、Yahoo!広告の数字を正しく入れるところを受け持ちます。
Google 広告のデータは、Google Cloud の転送サービス(BigQuery Data Transfer Service)で定期的に取り込めます。その公式の対応一覧には、2026年10月15日の時点で Yahoo の名前は見当たりませんでした(BigQuery Data Transfer Service の概要)。連携ツールを使わないなら、Yahoo!広告は管理画面か API でレポートを書き出し、ファイルを取り込むことになります。ここでの取り込み先は BigQuery ですが、ファイルの直し方は、ほかのデータの置き場に入れる場合も同じです。
書き出すのは、日別・キャンペーン別のレポート
書き出すレポートは、1行が「1日×1キャンペーン」になる形にします。列は、日、キャンペーンID、キャンペーン名、インプレッション数、クリック数、コスト、コンバージョン数です。月の合計は取り込んだあとで足せばよく、日別にしておくと、あとで日付ごとに置き換えられます。管理画面では、レポートの作成画面で「ファイル形式」を選んでダウンロードします。ダウンロードしたレポートが文字化けしていたら、環境に合ったファイル形式を選んで作り直すよう、公式のよくある質問に書かれています(レポートに関するよくある質問(検索広告))。
API では、レポートの定義に文字コードと合計行の出力の項目があります。Yahoo!広告 スクリプトのリファレンスでは、文字コードは UTF8(既定)・SJIS・UTF16LE から選べ(文字コードの項目)、合計行は既定で出力され、出さない指定もできます(合計行の項目)。定義を作ってからダウンロードするまでの手順は、公式の GitHub にあります(検索広告・ディスプレイ広告)。
文字コードは、選べるなら UTF-8 にします。2026年10月1日のお知らせでは、ディスプレイ広告(運用型)のインポート用データなどの CSV ダウンロード機能について、Shift_JIS によるダウンロードの提供を終了するとされています(実施日は2026年10月20日の予定とされていました。パフォーマンスレポートが対象かどうかは書かれていません。LINEヤフー for Business のお知らせ)。手元に Shift_JIS で保存した過去のレポートがあれば、取り込む前に UTF-8 に直します。
書き出したら、入れる前に4か所を見る
ファイルは、表計算ではなくテキストのまま開きます。表計算で開くと、日付や数の見た目が変わって表示され、ファイルの中身と違って見えることがあるからです。


①は合計行が付いていないかです。API の既定では合計行が出力され、公式の GitHub にあるディスプレイ広告の例では、データが無いときに Total,--,--,… の1行が出ます(検索広告の同じ例には、Total の行はありません)。管理画面で書き出したファイルにも付いていないか、行の先頭が何という文字かを、自分のファイルで確かめます。②は、数の列に「–」のような記号が混じっていないか。③は日付の形、④は列名とキャンペーン名が読めるかどうかです。
決めること1:合計行は、入れる前に外す
合計行を残したまま取り込むと、集計の画面は次の橙の枠のようになります。黒い見出しの方は、合計行を外してから入れた表で作った同じ画面です。


型を自動で決めさせて取り込むと、まず列名の「/」(コスト/コンバージョン数)で止まりました。列名の扱いを足して通した表が橙の枠で、合計行が「Total という日」と「– というキャンペーン」の1行として入り、①の合計を押し上げています。②のように日別の棒に Total が並べば気づけますが、③の表の「–」の行を見落としたり、日付で絞らずに合計だけを出したりすると、そのまま報告に載ります。合計行が混ざったこの表では、日付とキャンペーンIDの列が、日付や数ではなく文字の列として扱われていました。
取り込みの設定で「読めない行を1行まで捨てる」として合計行を落とす方法もあります。取り込みは成功し、表は正しい行数になりますが、捨てた行は取り込みの記録にしか残りません。合計行の無いファイルに同じ設定を使い回すと、データの行が1行壊れていても黙って捨てられます。合計行は、値を控えてから、ファイルの段階で消しておきます。
決めること2:文字コード・日付・「–」の書式をそろえる
文字コードは UTF-8 にそろえます。Shift_JIS のファイルを、列を指定して取り込むと、取り込みは成功し、行もすべて入りました。ところがキャンペーン名が化けていて、「ブランド名」を含むキャンペーンで絞ると、UTF-8 に直して入れれば14行出るところが0行です。合計を見るだけでは気づかず、名前で絞ったり、Google 広告の表と名前で突き合わせたりしたときに初めて分かります。BigQuery が CSV の取り込みで受け付ける文字コードに Shift_JIS は無いので(CSV データの読み込み)、ファイルの段階で UTF-8 に直します。直し方と、日本語の CSV に特有の文字の化け方は、日本語の CSV を BigQuery に入れる前の確かめの記事に書きました。
日付は 2026-09-01 の形にそろえます。2026/09/01 の形のまま日付の列に入れようとすると、全部の行で止まり、1行も入りませんでした。止まるので気づけますが、毎日の取り込みが止まれば、その日の数字は抜けます。日付の形は、取り込みの設定で指定することもできます。
「–」は空にします。数の列に「–」があると、その行で取り込みが止まりました。空にしておけば「値なし」として入ります。コスト/コンバージョン数のような割り算の列は、取り込んだあとでコストとコンバージョン数から割り直せるので、取り込まないという決め方もあります。数に付いた桁区切りのカンマ(”1,752″ の形)は、止まると思っていたところ、BigQuery では数としてそのまま入り、合計も変わりませんでした。ほかの置き場でも同じとは限らないので、カンマは外してから入れます。
決めること3:同じ日は、足さずに置き換える
毎日取り込んでいると、取り直した日や、期間の重なったファイルで、同じ日が2回入ります。足していく入れ方では、これがエラーにならずに残ります。


日別の棒で見れば1本だけ高いので分かりますが、月の合計に混ざると4.6%多いだけで、見ただけでは気づきません。
防ぎ方は、取り込み先の表を日付ごとの区画に分けておき、その日の区画を丸ごと入れ替えることです。置き換えた表では、9月7日はキャンペーンの数と同じ3行に戻り、コンバージョン数は後から書き出したファイルの値に置き換わりました。入れ替えは1日単位なので、ファイルも1日ずつに分けておきます。複数の日を含むファイルを1日の区画に入れようとすると、取り込みは止まりました。日付ごとの入れ替えは取り込みだけで済み、処理の料金はかかりません。
一部のキャンペーンだけを差し替えたいときや、1日ずつに分けられないファイルを扱うときは、いったん別の表に入れてから、日付とキャンペーンIDで行ごとに照らし合わせて更新するやり方が向きます。デモでも同じ結果になりましたが、こちらは小さな表でも毎回わずかに処理の料金がかかります。
コンバージョン数のように、あとから変わることのある数字は、何日前まで取り直すかを決めておき、その日数分を書き出して、同じように入れ替えます。日数の決め方は、月を締める日の決め方と同じで、月次レポートの記事の「締め日」に書きました。
明日は手で1回、合計を控えて確かめる
いきなり毎日の仕組みを作る前に、広告運用の担当が手で1回通してみます。使うのは、管理画面と、メモ帳のようなテキストエディタと、表計算ソフトです。取り込みの操作だけは、取り込み先を管理しているデータの担当に頼んでもかまいません。


- 管理画面から、先月分の日別・キャンペーン別のレポートを書き出し、テキストエディタで開いて4か所を見る(広告運用の担当)。
- 合計行があれば、そのコストの値を控える。無ければ、直す前のファイルを表計算で開き、コストの列を合計して控える(広告運用の担当)。
- 合計行を消し、「–」を空にし、日付を 2026-09-01 の形にそろえ、UTF-8 で保存する(広告運用の担当)。
- 日付ごとに置き換える形で取り込む(データの担当)。
- 取り込んだ表で同じ期間のコストを合計し、2の値と比べる(どちらか)。
同じファイルから作った数字どうしなので、差は0になるはずで、ずれを許す幅は要りません。1円でも違えば、1に戻ってファイルを開き直します。あわせて、日ごとの行数がキャンペーンの数と同じかも見ます。倍になっている日があれば、その日が二重に入っています。
これを毎日続けるなら、書き出しは API に替えるのが近道です。API の定義で文字コードを UTF8 にし、合計行を出さない指定をすれば、決めること1と文字コードは最初から要らなくなります(公式の定義の範囲の話で、このデモでは API は呼んでいません)。残るのは、記号と日付の形をそろえること、その日の分を置き換えて入れること、控えた合計と比べることで、ここは決まった処理なので、毎朝自動で回せます。差が出た日だけ担当に知らせる形にしておけば、人が見るのはその日だけになります。
Google 広告の表と並べる
Google 広告の転送で入る表とは、列の名前と単位をそろえて並べます。日付・キャンペーンID・インプレッション数・クリック数・コスト・コンバージョン数をそれぞれ対応させ、コストは、Google 広告の表ではマイクロ単位(100万分の1)なので、100万で割ってから足します(Google 広告の転送の表)。キャンペーンIDは媒体が違えば同じ値でも別のキャンペーンなので、どちらの媒体の行かを表す列を足しておきます。媒体ごとのコンバージョンを足した数をどう扱うかは、月次レポートの記事に書いたとおりです。列の対応は、最後の節に表で置きます。
この手順が受け持たないこと
この手順がそろえるのは、取り込んだ表の数字を、書き出したレポートと同じにすることです。レポートの数字そのものが正しいかは確かめられません。管理画面で選べる文字コード、管理画面で書き出したファイルに合計行が付くか、日付の形、コストが税込か税抜か、数の桁区切りの扱いは、公式の資料では見つけられませんでした。税の扱いは請求書と突き合わせて決め、ほかは自分のファイルを開いて確かめます。図の数字は数 KB の小さなファイルで取ったもので、数十万行のファイルでの所要時間は分かりません。
この画面の作り方
図と画面は、検索広告のレポートの列をなぞった CSV(キャンペーン3本×14日の42行と合計行)を形を変えて10通り作り、BigQuery(東京リージョン)にローカルのファイルから読み込んで作りました。一括の読み込みは料金がかかりません(BigQuery の料金)。型の自動検出(autodetect)は列名の「/」で止まり、エラー文の勧めどおり columnNameCharacterMap を V2 にして通しました(図のいちばん上)。列を指定した読み込みでは、日付の形は dateFormat、「–」は nullMarkers で通り、合計行は maxBadRecords=1 で落ちました。直す処理は Python で、要点は次のとおりです。
text = open(src, 'rb').read().decode('cp932')      # 元が UTF-8 なら 'utf-8'
rd = csv.reader(io.StringIO(text)); head = next(rd)
for row in rd:
    if row and row[0] == 'Total':                     # 合計行を外す(先頭の文字は自分のファイルで確かめる)
        continue
    row[0] = row[0].replace('/', '-')                 # 日付を YYYY-MM-DD に
    row = row[:3] + [('' if v == '--' else v.replace(',', '')) for v in row[3:]]
    out.append(row)
# UTF-8(BOM なし)で書き出し、1日ごとのファイルにも分ける
日付ごとの入れ替えは、日付で分割した表の、その日の区画(表名の後ろに区切りの記号と 20260907 のような日付を付けて指定)へ、WRITE_TRUNCATE(上書き)で読み込みました。複数の日を含むファイルでは Some rows belong to different partitions rather than destination partition で止まりました。行ごとの照らし合わせ(別の表に入れてから MERGE)は、処理した量が数 KB でも、参照する表ごと・クエリごとに最低 10 MB という料金の決まりで、1回 20 MiB が課金されました。
| Yahoo!広告のレポートの列 | Google 広告の転送の列 |
|---|---|
| 日 | segments_date |
| キャンペーンID | campaign_id |
| キャンペーン名 | campaign_name(数字の表とは別の Campaign の表にあり、キャンペーンIDでつなげて引く) |
| インプレッション数 | metrics_impressions |
| クリック数 | metrics_clicks |
| コスト | metrics_cost_micros ÷ 1,000,000 |
| コンバージョン数 | metrics_conversions |
並べるときは、媒体を表す列を付けて UNION ALL でつなぎました(Google 広告の側は、転送の列名をなぞった小さな表で確かめました。実際の転送では日付や数字の列は CampaignBasicStats の表にあるので、名前を付けるなら Campaign の表とつなげます)。
SELECT 'yahoo' AS media, day, SUM(impressions) AS impressions, SUM(clicks) AS clicks,
  SUM(cost) AS cost, SUM(conversions) AS conversions
FROM `blog_demo.yahoo_search_daily_merge`
WHERE day BETWEEN '2026-09-01' AND '2026-09-03' GROUP BY day
UNION ALL
SELECT 'google', segments_date, SUM(metrics_impressions), SUM(metrics_clicks),
  CAST(SUM(metrics_cost_micros) / 1000000 AS INT64), CAST(SUM(metrics_conversions) AS INT64)
FROM `blog_demo.yahoo_u1_gads_like`
WHERE segments_date BETWEEN '2026-09-01' AND '2026-09-03' GROUP BY segments_date
まずは先月分で、控えた合計と取り込んだ合計を比べる
明日からできるのは、先月分の Yahoo!広告のレポートを日別・キャンペーン別で書き出し、テキストで開いて4か所を見て、コストの合計を控えることです。そのうえで、いま取り込んでいる表の先月のコストの合計と比べます。差が0でなければ、合計行・書式・同じ日の二重のどれかが残っています。
手で1回通したあと、書き出しを API に替えて、直す・置き換える・合計を比べる・差が出たら知らせる、までを毎朝自動で回す仕組みは、当社の広告運用の支援とBigQuery の導入支援で作れます。
執筆・監修
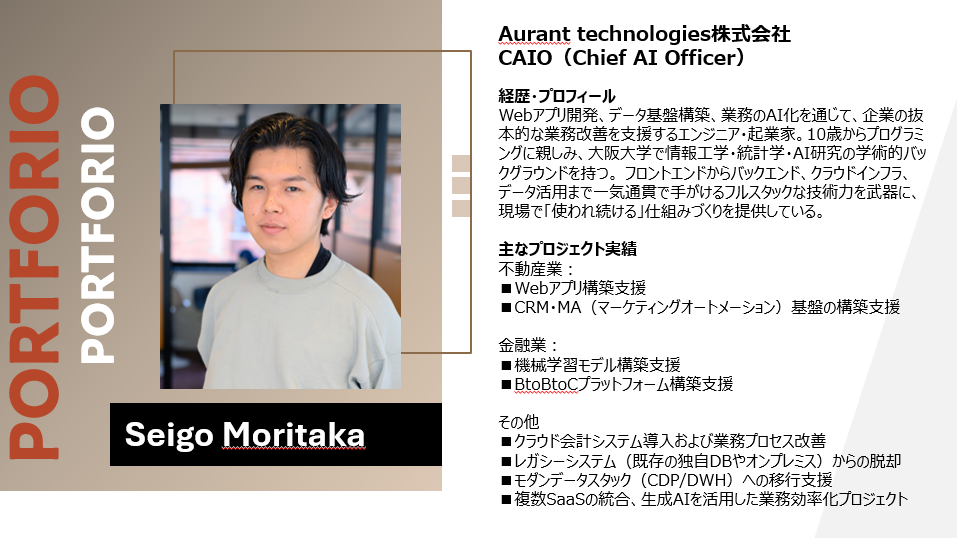
Aurant Technologies CAIO(Chief AI Officer)
広告の運用とデータの仕組みづくりを支援する立場から、媒体の数字を自社でそろえて見たい広告の担当者の方向けにまとめています。
広告運用支援
Google広告・Meta広告・LINE広告・Yahoo!広告の運用を、GA4やCRMとのデータ連携を土台に立て直します。コンバージョン計測の整備から媒体をまたいだ改善まで、社内で判断できる形で伴走します。