生成AI 社内利用 情報漏洩防止ガイド 2026:実践ルール・技術対策・リスクシナリオ
生成AIの社内利用は業務効率化の鍵ですが、情報漏洩リスクも伴います。本記事では、具体的なリスクシナリオから実践的なルール策定、技術的対策、従業員教育まで、企業が安全に生成AIを活用するための全ステップを解説します。
目次 クリックで開く
生成AIの社内利用で情報漏洩を防ぐ!実践的ルールと技術対策を徹底解説
生成AIの社内利用は業務効率化の鍵ですが、情報漏洩リスクも伴います。本記事では、具体的なリスクシナリオから実践的なルール策定、技術的対策、従業員教育まで、企業が安全に生成AIを活用するための全ステップを解説します。
生成AIの社内利用がもたらす革新と潜在リスク
生成AIは、ビジネスのあり方を根本から変革する可能性を秘めています。その技術は日々進化し、さまざまな業界で業務効率化や生産性向上への期待が高まっています。しかし、その革新的な力の裏側には、情報漏洩や誤情報生成といった潜在的なリスクも潜んでいます。私たちは、貴社がこの新しい技術を安全かつ最大限に活用できるよう、その両面を深く理解することが不可欠です。
業務効率化・生産性向上への期待と具体的な活用事例
生成AIは、これまで人間が多くの時間を費やしてきた定型業務や創造的なタスクにおいて、驚くべき効率化を実現します。例えば、コンテンツ生成、データ分析、コード開発支援など、その活用範囲は多岐にわたります。これにより、従業員はより戦略的で付加価値の高い業務に集中できるようになり、企業全体の生産性向上に貢献します。
ある調査によれば、生成AIの導入によって、企業の約7割が業務効率の改善を実感していると報告されています(出典:日本経済新聞社「生成AI利用実態調査2023」)。具体的な活用事例としては、以下のようなものが挙げられます。
- マーケティング部門: ターゲット顧客に合わせたSNS投稿案やブログ記事の原案作成、広告コピーの多言語展開、市場トレンドの迅速な分析。これにより、キャンペーン企画のリードタイムを大幅に短縮し、よりパーソナライズされた顧客体験を提供できます。
- 営業部門: 顧客へのパーソナライズされたメール作成支援、商談資料の自動生成、競合分析レポートの作成。これにより、営業担当者は提案活動に集中でき、成約率の向上に繋がります。
- 開発部門: プログラミングコードの自動生成、既存コードのバグ検出・修正支援、技術ドキュメントの自動作成。開発期間の短縮と品質向上が期待できます。
- バックオフィス部門(総務・経理・人事): 社内FAQの自動応答システム構築、定型的な問い合わせ対応の自動化、契約書や規約の要約。従業員の問い合わせ対応負荷を軽減し、間接部門の効率化を推進します。
これらの事例からもわかるように、生成AIは単なる自動化ツールではなく、業務プロセスそのものを変革し、新たな価値創造を支援する強力なパートナーとなり得ます。以下に、部門別の活用事例と期待効果をまとめました。
| 部門 | 生成AI活用事例 | 期待される効果 |
|---|---|---|
| マーケティング | ブログ記事・SNS投稿案作成、広告コピー生成、市場トレンド分析 | コンテンツ制作の時間短縮、ターゲット精度向上、多様な視点での企画立案 |
| 営業 | 顧客向け提案書・メール作成支援、商談スクリプト生成、競合分析 | 提案活動の効率化、顧客エンゲージメント向上、成約率改善 |
| 開発 | コード自動生成・レビュー、テストケース作成、ドキュメント自動生成 | 開発期間短縮、品質向上、エンジニアの負担軽減 |
| カスタマーサポート | FAQ自動応答、顧客問い合わせの要約・分類、対応履歴分析 | 顧客満足度向上、サポートコスト削減、対応品質の均一化 |
| バックオフィス | 社内規程の要約、定型報告書作成、データ入力支援 | 間接業務の効率化、従業員の負担軽減、ヒューマンエラー削減 |
情報漏洩・誤情報生成・著作権侵害などの潜在リスク
生成AIの導入がもたらす恩恵は大きい一方で、その利用には重大なリスクが伴います。特に、情報漏洩は企業にとって最も懸念されるリスクの一つであり、一度発生すれば企業の信頼失墜や法的責任に直結しかねません。
- 情報漏洩: 従業員が機密情報や個人情報を含むデータをプロンプトとして入力してしまうことで、AIがこれを学習データとして取り込み、意図せず他者に開示したり、将来の生成結果に反映させてしまったりする危険性があります。また、AIサービスによっては入力データがサービス提供者側に送信・保存されるため、サプライチェーン全体でのセキュリティリスクも考慮する必要があります(出典:IPA「AIの利用に関する注意喚起」)。
- 誤情報生成(ハルシネーション): 生成AIは、時に事実に基づかない情報やもっともらしい嘘(ハルシネーション)を生成します。これを誤って業務に利用したり、顧客に提供したりした場合、企業の信用問題に発展するだけでなく、誤った意思決定を招き、甚大な損害を引き起こす可能性があります。
- 著作権侵害: AIが学習したデータには、著作権で保護されたコンテンツが含まれている可能性があります。AIが生成したコンテンツが、既存の著作物と酷似していた場合、意図せず著作権侵害に問われるリスクがあります。特に画像や文章コンテンツを生成する際には、このリスクへの配慮が不可欠です。
- プライバシー侵害: 個人情報を含むデータで学習されたAIが、特定の個人を識別できる情報を生成したり、プライバシーに関する機微な情報を引き出したりする可能性があります。GDPRや日本の個人情報保護法など、各国・地域のプライバシー規制を遵守するための対策が求められます。
- セキュリティリスク: 悪意のあるプロンプトによってAIの振る舞いを操作したり(プロンプトインジェクション)、生成されたコードに脆弱性が含まれていたりする可能性も考慮しなければなりません。
これらのリスクは、貴社のブランドイメージ、法的責任、ひいては事業継続性に深刻な影響を及ぼす可能性があります。そのため、生成AIの導入は、これらのリスクを十分に理解し、適切に対策を講じた上で行う必要があります。
なぜ今、情報漏洩対策を核としたルール策定が急務なのか?
生成AIの利用が急速に拡大する中で、情報漏洩対策を核とした社内ルールの策定は、もはや待ったなしの課題です。その理由は以下の通りです。
- リスクの顕在化と拡大: 生成AIの普及に伴い、意図的か否かを問わず情報漏洩のリスクは高まっています。従業員が気軽にAIを利用する一方で、リスクへの認識が不足している場合、重大なインシデントに繋がります。
- 法的・規制上の要請: 各国政府は生成AIに関する規制やガイドラインの策定を進めています。例えば、EUではAI法案の議論が進み、日本でも経済産業省が「生成AIに関するガイドライン」を公開しています。これらの動向を踏まえ、企業は法的要件を遵守し、将来的な規制強化にも対応できる体制を構築する必要があります(出典:経済産業省「生成AIに関するガイドライン」)。
- 企業信頼性とブランドイメージの維持: 一度情報漏洩や誤情報による問題が発生すれば、顧客や取引先からの信頼は失墜し、ブランドイメージは大きく損なわれます。これは、短期的な売上減少だけでなく、長期的な企業価値の毀損にも繋がります。
- 従業員の混乱とセキュリティ意識の向上: 明確なルールがない状況では、従業員はAIをどのように利用すれば良いか分からず、不安を感じる可能性があります。適切なルールを定めることで、従業員は安心してAIを活用でき、同時にセキュリティ意識の向上にも繋がります。
- 競争優位性の確保: 他社が生成AIを安全かつ効果的に活用し、業務変革を進める中で、貴社がリスクを恐れて活用を躊躇したり、インシデントによって足踏みしたりすれば、競争優位性を失います。適切なルールは、リスクを管理しつつ、イノベーションを推進するための基盤となります。
これらの理由から、経営層がリーダーシップを発揮し、情報セキュリティ部門、法務部門、IT部門が連携して、生成AIの社内利用に関する明確なルールを早急に策定することが不可欠です。これにより、貴社は生成AIの恩恵を最大限に享受しつつ、潜在的なリスクを最小限に抑え、持続的な成長を実現できます。
情報漏洩につながる具体的なリスクシナリオと事例
生成AIの社内利用は、業務効率化や新たな価値創造の可能性を秘める一方で、情報漏洩という重大なリスクと常に隣り合わせです。貴社が取るべき対策を検討する前に、どのような経路で情報漏洩が発生しうるのか、具体的なシナリオを理解しておくことが不可欠です。
機密情報の意図しない学習と再出力リスク
多くのパブリックな生成AIモデルは、ユーザーが入力したデータをサービスの改善やモデルの学習に利用する可能性があります。これは、貴社の機密情報が意図せずAIの学習データセットに取り込まれ、将来的に全く関係のない他者のプロンプトへの応答として出力されてしまうリスクを意味します。
- 具体的な漏洩経路の例:
- 開発中の新製品の仕様書や設計図の一部をAIに投入し、アイデア出しや文章要約に利用する。
- 未公開のマーケティング戦略やキャンペーン計画をAIにレビューさせたり、キャッチコピーを生成させたりする。
- M&Aに関する検討資料や財務情報をAIに分析させ、レポート作成を試みる。
- 想定される情報漏洩の種類:
- 企業秘密(製品開発情報、技術情報、ノウハウ)
- 未公開のビジネス戦略、競合優位性に関する情報
- 法的文書、契約情報
実際に、一部のAIプロバイダーの利用規約には、入力データがモデルの学習に利用される可能性が明記されています(出典:OpenAI利用規約、Google Gemini(旧Bard)利用規約など)。たとえプロバイダー側でデータが匿名化されたとしても、特定の文脈や組み合わせによって情報が特定されるリスクはゼロではありません。このリスクを軽減するためには、利用規約を詳細に確認し、機密情報を扱わない、あるいはプライベートなAI環境を構築するといった対策が重要です。
個人情報・顧客データの入力による漏洩リスク
従業員が業務効率化を目的として、顧客の個人情報、従業員のデータ、取引先の機密情報などを生成AIに入力してしまうケースも頻繁に発生します。
- 具体的な漏洩経路の例:
- 顧客リストのサマリー作成や、個別の顧客へのメール文面作成のために、氏名、連絡先、購入履歴などの個人情報をAIに入力する。
- 契約書の個人情報部分の自動生成や校正をAIに依頼する際、機微な情報を含む契約書全体をアップロードする。
- 従業員の評価レポートや人事関連の文書作成にAIを活用する際、個人の業績や健康情報などの機密性の高いデータを入力する。
- 社内調査やアンケート結果の分析で、回答者の属性情報(年齢、性別、部署など)が含まれる生データをAIに入力する。
- 想定される情報漏洩の種類:
- 顧客の氏名、住所、電話番号、メールアドレス、購入履歴などの個人情報
- 従業員の氏名、役職、評価、健康情報などの人事情報
- 取引先の企業情報、担当者情報、契約詳細
- GDPRや個人情報保護法などの規制対象となるデータ
これらの情報がAIプロバイダーのサーバーに保存されたり、学習データとして利用されたりすることで、情報漏洩のリスクが高まります。過去には、従業員が顧客情報をChatGPTに入力したことで情報漏洩が発生した事例も報告されており、企業が法的責任を問われる可能性も十分にあります(出典:国内外の報道機関による情報漏洩事例、データプライバシーに関する専門機関の報告)。
生成AIの脆弱性を悪用したサイバー攻撃の可能性
生成AIシステム自体や、AIと連携する社内システムに存在する脆弱性が、サイバー攻撃の標的となるリスクも無視できません。AI特有の脆弱性を悪用した攻撃手法が進化しており、貴社のセキュリティ対策もそれに合わせて進化させる必要があります。
- 具体的な攻撃手法と漏洩経路の例:
- プロンプトインジェクション: 悪意のあるプロンプトをAIに入力することで、AIの挙動を操作し、本来アクセスできないはずの機密情報(例:AIの学習データ、内部設定)を引き出したり、不正なアクションを実行させたりする。
- モデルポイズニング: 攻撃者がAIの学習データに不正なデータを意図的に混入させることで、AIの出力に偏りを与えたり、特定のプロンプトに対して機密情報を出力させたりする。
- API連携の脆弱性: 生成AIサービスと貴社の社内システム(SaaS、データベースなど)を連携する際のAPIにセキュリティホールが存在する場合、そこを突破されてシステムへの不正アクセスやデータの窃取が行われる。
- データ漏洩: AIモデルの出力に含まれる脆弱性や、AIが生成したコードに潜在的なセキュリティリスクが含まれている場合、それらを利用して攻撃者がシステムに侵入する。
- 想定される情報漏洩の種類:
- 企業秘密、顧客情報、従業員情報など、AIがアクセス可能なあらゆるデータ
- システムへの不正アクセス、マルウェア感染によるさらなる情報窃取
- 業務妨害、システム停止
NIST(米国標準技術研究所)はAIリスク管理フレームワークを公開し、OWASP(Open Web Application Security Project)は「OWASP Top 10 for LLM Applications」として、大規模言語モデル(LLM)特有のセキュリティリスクと対策を提示しています(出典:NIST AI Risk Management Framework, OWASP Top 10 for LLM Applications)。これらのガイドラインを参考に、AIのセキュリティ対策を強化することが重要です。
従業員の不注意や誤解による情報流出の実例
最も身近でありながら、最も発生しやすい情報漏洩の原因の一つが、従業員の不注意や生成AIに対する誤解によるヒューマンエラーです。利用ルールが不明確であったり、ルールの重要性が十分に理解されていなかったりすると、意図せず機密情報が流出してしまう事態を招きます。
- 具体的な漏洩経路の例:
- 業務効率化を優先し、社外秘の企画書や顧客との商談議事録をそのままコピー&ペーストしてAIに入力し、要約や構成案の生成を依頼する。
- 生成AIが作成した文章やコードに、貴社固有の機密情報や脆弱性が含まれていることに気づかず、そのまま外部に公開したり、システムに組み込んだりする。
- AIの出力が事実と異なる「ハルシネーション」を起こしているにもかかわらず、その内容を検証せずに重要な意思決定に利用したり、外部に発信したりする。
- AIチャットボットとの会話履歴に機密情報が残っていることを認識せず、共有設定のまま放置する。
例えば、開発部門のエンジニアが新製品の設計図の一部をパブリックな生成AIに入力してアイデア出しを行う、といったことは起こり得ます。悪意がなくても、利便性を追求するあまり情報が流出してしまう可能性は十分にあります。
従業員への継続的な教育と、具体的かつ分かりやすいガイドラインの策定、そして利用状況の適切な監視が、このようなリスクを軽減する上で不可欠です。
生成AIの社内利用における情報漏洩リスクシナリオをまとめると以下のようになります。
| リスクシナリオ | 具体的な漏洩経路の例 | 想定される情報漏洩の種類 | 基本的な対策の方向性 |
|---|---|---|---|
| 機密情報の意図しない学習と再出力 | パブリックAIに開発中の製品情報、未公開戦略を入力 | 企業秘密、ノウハウ、知的財産 | 利用規約の厳格な確認、プライベートAI環境の導入、データマスキング |
| 個人情報・顧客データの入力 | 顧客リスト、契約書内の個人情報をAIで要約・校正 | 顧客個人情報、従業員情報、取引先情報(GDPR, 個人情報保護法関連) | 法規制遵守の徹底、データマスキング、匿名化ツールの活用 |
| 生成AIの脆弱性を悪用したサイバー攻撃 | プロンプトインジェクション、モデルポイズニング、API連携の脆弱性 | 企業秘密、顧客情報、システムアクセス権、業務妨害 | セキュリティ診断、定期的な脆弱性スキャン、AIセキュリティ専門家との連携 |
| 従業員の不注意や誤解 | 機密情報をAIにコピペ、生成物に機密情報が含まれることに気づかず公開 | 企業秘密、ノウハウ、顧客情報、ブランドイメージ毀損 | 従業員への継続的な教育、具体的な利用ガイドラインの策定、利用ログ監視 |
生成AI社内利用ルールの策定における基本原則
目的の明確化と利用促進・リスク抑制のバランス
生成AIの社内利用ルールを策定する上で、まず貴社が生成AIから何を得たいのか、その「目的」を明確にすることが不可欠です。単に「情報漏洩を防ぐ」という守りの視点だけでなく、「業務効率化」「創造性の向上」「新規事業の創出」といった攻めの視点も併せ持つべきです。これらの目的を明確にすることで、ルールの方向性が定まり、従業員も「何のためにこのルールがあるのか」を理解しやすくなります。
しかし、利用促進とリスク抑制は時に相反する側面を持ちます。例えば、全社的な利用を許可すれば生産性向上が期待できる一方で、情報漏洩のリスクも高まります。このバランスを取ることがルールの肝となります。私たちは、このバランスを取るために、以下の点を考慮することを推奨しています。
- リスクレベルに応じた利用範囲の設定: 機密性の高い情報を取り扱う部署や業務では利用を制限する、あるいは特定のセキュアなAIツールのみを許可するなど、段階的なアプローチを取ります。
- メリットとリスクの具体的な提示: 従業員に対して、生成AIがもたらすメリット(例:資料作成時間の50%削減、アイデア創出の加速)と、リスク(例:機密情報の外部流出による損害、著作権侵害による法的リスク)を具体的に示し、意識向上を図ります。
- サンドボックス環境の活用: まずは情報漏洩リスクの低い公開情報やダミーデータのみを扱えるサンドボックス(砂場)環境を提供し、従業員が安全に生成AIに慣れる機会を設けることも有効です。
ルール策定の初期段階では、リスク抑制を重視しつつ、利用状況や技術の進化に合わせて段階的に利用範囲を広げていく「プログレッシブなアプローチ」が現実的です。これにより、貴社は生成AIの恩恵を享受しつつ、潜在的なリスクを最小限に抑えることが可能になります。
法令遵守(個人情報保護法、著作権法など)の徹底
生成AIの社内利用においては、既存の様々な法令を遵守することが絶対条件です。特に「個人情報保護法」と「著作権法」は、生成AIの特性上、常に注意を払うべき重要なポイントとなります。ルール策定にあたっては、これらの法令が生成AIの利用にどう影響するかを具体的に明記し、従業員に周知徹底する必要があります。
個人情報保護法に関しては、生成AIに個人情報や機微な情報を入力することによる情報漏洩リスクが最も懸念されます。匿名加工情報や仮名加工情報の活用を検討し、個人情報保護委員会のガイドラインを参考に、適切なデータハンドリングの原則を定めることが重要です。また、著作権法に関しては、生成AIが学習するデータの著作権、そして生成されたコンテンツの著作権帰属や既存著作物との類似性リスクが課題となります。生成AIサービスの利用規約を確認し、生成物の商用利用や公開に関する制限を明確にすることが求められます。
さらに、不正競争防止法に基づく営業秘密の保護や、貴社の事業領域に特有の業界規制(例:金融業界のFISC安全対策基準、医療業界の医療情報システム安全管理に関するガイドライン)にも配慮が必要です。グローバルに事業を展開する企業であれば、GDPR(EU一般データ保護規則)やCCPA(カリフォルニア州消費者プライバシー法)といった国際的なプライバシー規制への対応も視野に入れる必要があります。
以下に、主要な法令と生成AI利用時の注意点をまとめました。
| 関連法令 | 生成AI利用時の主な注意点 | 推奨される対策 |
|---|---|---|
| 個人情報保護法 | 個人情報、機微な情報の入力による情報漏洩リスク。 | 個人情報の入力禁止を明文化。匿名加工情報や仮名加工情報の活用。個人情報保護委員会ガイドラインの参照。 |
| 著作権法 | 生成AIの学習データの適法性。生成物の著作権帰属、既存著作物との類似性リスク。 | 生成AIサービスの利用規約確認。既存著作物との酷似を避ける指示。生成物の商用利用・公開範囲の制限。 |
| 不正競争防止法 | 営業秘密の入力による漏洩リスク。 | 営業秘密の入力禁止を明文化。プロンプト管理の徹底。 |
| 各国・地域のプライバシー規制(GDPR、CCPAなど) | 国境を越えたデータ転送や処理における規制遵守。 | 各国のデータ保護要件の確認。グローバル利用時のデータガバナンス体制構築。 |
| 業界固有の規制(金融、医療など) | 特定の業界における厳格な情報管理要件。 | 該当業界の規制当局ガイドラインを遵守。専門家との連携。 |
(出典:個人情報保護委員会「生成AIサービスと個人情報の適正な取扱いについて」、文化庁「AIと著作権」など)
従業員の理解と協力体制の構築の重要性
どんなに精緻なルールを策定しても、実際にそれを利用・遵守するのは従業員です。そのため、従業員一人ひとりがルールの意図を理解し、自発的に協力する体制を構築することが、ルール運用の成否を分けます。一方的な通達だけでは、ルールは形骸化し、かえって生産性を阻害する要因にもなりかねません。
従業員の理解と協力を得るためには、以下の施策が有効です。
- ルール策定プロセスへの巻き込み: 従業員代表や各部門のキーパーソンをルール策定プロセスに初期段階から参加させることで、現場の視点を取り入れ、ルールの実効性を高めます。これにより、「自分たちが作ったルール」という意識が醸成され、遵守意欲も向上します。
- 定期的かつ実践的な研修・教育: ルールの内容だけでなく、なぜそのルールが必要なのか、違反した場合のリスク、具体的な利用事例とNG事例などを交えた研修を定期的に実施します。特に、安全なプロンプト作成方法や、社内承認済みツールの使い方に焦点を当てた実践的な内容が効果的です。
- Q&A体制と相談窓口の設置: 従業員が疑問や不安を感じた際に、気軽に相談できる窓口(例:法務部門、情報システム部門、各部署のAI推進担当)を設置し、迅速かつ的確なフィードバックを提供します。これにより、誤った利用や潜在的なリスクを早期に発見・対処できます。
- ルール遵守を促すインセンティブと違反時の対応: ルールを遵守し、安全かつ効果的に生成AIを活用している従業員を評価する仕組みを検討することも、ポジティブな動機付けとなります。一方で、ルール違反があった場合には、公平かつ透明性のある対応基準を設け、適切に処理する体制を構築します。
従業員が生成AIを「恐れるもの」ではなく、「正しく使えば強力な味方になるもの」と捉えられるようなコミュニケーションを継続的に行うことが、貴社全体のAIリテラシー向上にも繋がります。
継続的な見直しと改善を前提とした柔軟な運用
生成AI技術は、日進月歩で進化しています。昨日まで不可能だったことが今日には可能になり、新しいリスクや利用方法が次々と生まれています。このような状況下で、一度策定したルールが永続的に有効であると考えるのは非現実的です。そのため、生成AIの社内利用ルールは、「継続的な見直しと改善」を前提とした、柔軟な運用体制を構築することが極めて重要です。
私たちは、以下の要素をルール運用に組み込むことを推奨します。
- 定期的なレビューサイクルの設定: 四半期ごと、あるいは半年に一度など、定期的にルールを見直すサイクルを設けます。この際、最新のAI技術動向、新たな脅威情報、法令改正などを考慮に入れます。
- フィードバック収集の仕組み: 従業員からの利用実態に関するフィードバック(例:使いづらい点、改善提案、新しい利用アイデア)を積極的に収集する仕組み(例:アンケート、ヒアリング、専用チャネル)を設けます。また、生成AIツールの利用ログを匿名化して分析することも、実態把握に役立ちます。
- ルール改定プロセスの透明化: ルールが改定される際には、その背景、変更点、従業員への影響などを明確に伝え、透明性を確保します。これにより、従業員の納得感を高め、混乱を防ぎます。
- 段階的なルール適用とパイロット導入: 新しい機能やモデルの導入、あるいは大規模なルール変更を行う前に、特定の部署や業務でパイロット導入を実施し、その効果とリスクを検証します。これにより、全社展開時のリスクを低減し、より実効性の高いルールに磨き上げることができます。
「完璧なルールは存在しない」という前提に立ち、現場の声を吸い上げながら、変化に即応できるアジャイルなルール運用を目指すことが、貴社の生成AI活用を成功させる鍵となります。私たちも、常に最新の動向をウォッチし、貴社のルールが常に最適な状態を保てるよう支援いたします。
【実践】情報漏洩を防ぐための具体的なルール項目
生成AIを社内で安全に活用するためには、ただ利用を許可するだけでなく、具体的なルールを設けて運用することが不可欠です。ここでは、情報漏洩リスクを最小限に抑えつつ、AIの恩恵を最大限に引き出すための実践的なルール項目を詳しく解説します。
利用可能なAIツールの指定と制限(無料版・有料版の区別)
貴社内で利用を許可する生成AIツールを明確に指定することは、情報セキュリティ対策の第一歩です。市場には多様な生成AIツールが存在しますが、そのセキュリティレベルやデータ利用ポリシーは大きく異なります。特に、無料版のツールは利便性が高い一方で、入力されたデータをAIモデルの学習に利用したり、十分なセキュリティ対策が講じられていなかったりするケースがあります。
例えば、一部の無料AIサービスでは、ユーザーが入力した情報を「サービス改善のため」として利用規約に明記している場合があります。これは、意図せず貴社の機密情報が外部に流出するリスクをはらんでいます。実際、大手企業が無料AIツールに機密情報を入力し、情報漏洩につながった事例も複数報告されています(出典:日本経済新聞、2023年)。
有料版のエンタープライズ向けAIツールでは、多くの場合、入力データの学習利用停止オプションや、データ暗号化、アクセス制御、監査ログなどの高度なセキュリティ機能が提供されます。また、データが特定の地域に限定して保存される「データレジデンシー」に対応しているサービスもあり、各国の法規制遵守にも役立ちます。
貴社では、まず利用を許可するAIツールをリストアップし、それ以外のツールの利用を禁止するポリシーを策定すべきです。この際、以下の点を考慮してツールを選定し、社内規定に盛り込みましょう。
- データ利用ポリシーの確認:入力データがAIモデルの学習に利用されないことを明確に保証しているか。
- セキュリティ機能:データ暗号化、アクセス制御、監査ログ、脆弱性診断などの機能が充実しているか。
- データレジデンシー:データの保存場所が貴社のセキュリティ要件や法規制に適合しているか。
- ベンダーの信頼性:セキュリティに関する実績や認証(ISO 27001など)を有しているか。
- 契約内容:SLA(サービス品質保証契約)や責任範囲が明確になっているか。
貴社が特定の業界に属する場合(金融、医療など)、業界特有の規制(例:GDPR、HIPAA、日本の個人情報保護法)を遵守できるツールであるかどうかの確認も不可欠です。私たちも、お客様の業種や規模に応じて、最適なAIツールの選定から導入支援まで幅広くサポートしています。
以下に、無料版と有料版AIツールのセキュリティ特性に関する比較表を示します。
| 項目 | 無料版AIツール(一般的な傾向) | 有料版AIツール(エンタープライズ向け) |
|---|---|---|
| データ学習利用 | ユーザーの入力データがモデル学習に利用される可能性が高い。 | 入力データの学習利用を停止できるオプションが提供されることが多い。 |
| データ暗号化 | 基本的な暗号化のみの場合がある。 | 転送中および保存中のデータに対する高度な暗号化が実装されている。 |
| アクセス制御 | 個人アカウントベースで、組織的な管理機能が限定的。 | SSO(シングルサインオン)、ロールベースアクセス制御(RBAC)など、組織的な管理が可能。 |
| データレジデンシー | データの保存場所を指定できないことが多い。 | データの保存リージョンを選択できるサービスが多い。 |
| 監査ログ | 提供されないか、限定的な場合が多い。 | 詳細な利用ログやアクセスログが提供され、監査に利用可能。 |
| SLA(サービス品質保証) | 提供されない。 | 稼働率やサポート体制に関するSLAが契約で保証される。 |
入力情報の制限とガイドライン(機密情報・個人情報の入力禁止ルール)
生成AI利用における情報漏洩リスクの最も直接的な原因は、機密情報や個人情報の意図しない入力です。このリスクを回避するためには、どのような情報を入力してはいけないのかを明確にし、具体的なガイドラインを策定することが不可欠です。
まず、「機密情報」と「個人情報」の定義を社内で統一し、従業員に周知徹底します。
- 機密情報:未公開の事業戦略、財務データ、顧客リスト、製品開発情報、特許関連情報、サプライヤー情報、社内システムに関する情報など、外部に知られると貴社に損害を与える可能性のあるあらゆる情報。
- 個人情報:特定の個人を識別できる情報(氏名、住所、電話番号、メールアドレス、顔写真、マイナンバー、クレジットカード情報、健康情報など)。匿名化されていない顧客データや従業員データもこれに該当します。
これらの情報を生成AIツールに直接入力することは、原則として禁止すべきです。もし、業務上どうしてもAIの支援が必要な場合は、以下の対策を講じる必要があります。
- 匿名化・仮名化の徹底:個人情報や機密情報を含むデータをAIに入力する前に、識別可能な情報を削除または置き換える処理を行います。例えば、顧客リストを分析する際には、氏名や連絡先を削除し、顧客IDや属性データのみを入力します。
- 抽象化・一般化:具体的な数値を抽象的な表現に置き換えたり、特定の固有名詞を一般名詞に変換したりして、情報の内容を損なわない範囲で機密性を低減させます。
- RAG(Retrieval Augmented Generation)の活用:貴社内のセキュアな環境に構築されたデータベースから情報を検索し、その情報をAIに与えて回答を生成させるRAGの仕組みを導入することで、機密情報を直接外部のAIサービスに送信することなく、AIの能力を最大限に活用できます(出典:OpenAI、2023年)。これにより、AIモデルが学習に利用するデータは貴社内で管理されたものに限定され、外部への情報漏洩リスクを大幅に低減できます。
- 入力情報のレベルに応じた利用制限:入力する情報の機密性レベルに応じて、利用可能なAIツールや利用者を制限するルールを設けることも有効です。例えば、社外公開情報レベルであれば無料AIツールも一部許可するが、社内限定情報であれば承認済みの有料AIツールのみ、というように段階を設けます。
私たちは、貴社の情報セキュリティポリシーに合わせたAI利用ガイドラインの策定を支援し、従業員向けトレーニングプログラムの提供も行っています。従業員が「これは入力していいのか?」と迷った際に参照できる具体的な事例集やQ&Aを作成し、誤った利用を防ぐ仕組みを構築することが重要です。
| 入力情報の機密性レベル | 具体例 | 入力の可否 | 推奨される対応 |
|---|---|---|---|
| 機密レベル3(極秘) | 未公開の財務諸表、新製品の設計図、顧客の個人識別情報を含むリスト、特許申請中の技術詳細 | 禁止 | 匿名化・抽象化が不可能であれば、AI利用は避ける。RAG環境での利用を検討。 |
| 機密レベル2(社外秘) | 社内会議の議事録(特定の個人情報を含まない)、部門ごとの売上データ、一般的な競合分析資料 | 原則禁止 | 匿名化・仮名化・抽象化を徹底する。承認済み有料AIツールでのみ利用を検討。 |
| 機密レベル1(社内限定) | 一般的な社内連絡文、業務手順書、公開予定のない企業ブログの下書き | 条件付きで許可 | 個人情報を含まないことを確認。承認済み有料AIツールでの利用を推奨。 |
| 公開情報レベル | 公開されているニュース記事、一般的な市場調査レポート、公開済みのプレスリリース | 許可 | ツールの利用規約を確認し、情報源を明記する。 |
出力情報の確認と利用に関するルール(ファクトチェック、著作権確認)
生成AIが出力する情報は、あくまで「生成されたもの」であり、必ずしも事実に基づいているとは限りません。特に、AIが事実ではない情報をあたかも事実であるかのように生成する「ハルシネーション(Hallucination)」は、情報漏洩とは異なる形でのリスク、すなわち「誤情報の拡散」や「企業の信頼性低下」につながる可能性があります。
そのため、AIの出力情報をそのまま利用することは避け、以下の確認プロセスを義務付ける必要があります。
- ファクトチェックの徹底:
- 情報源の確認:AIが参照したとされる情報源や、提示された事実の裏付けとなる信頼できる情報源を必ず確認します。
- 複数ソースでの検証:AIの出力内容を、貴社内の専門知識や複数の外部情報源(公的機関のデータ、信頼できるニュースメディア、学術論文など)と照らし合わせて検証します。
- 専門家によるレビュー:特に重要な意思決定に関わる情報や、専門性の高い内容については、必ず担当部署の専門家や責任者によるレビューを義務付けます。
ある調査では、生成AIの出力内容をファクトチェックせずに利用した結果、誤った情報が社外に公開され、訂正に多大なコストと時間を要した事例が報告されています(出典:ガートナー、2023年)。
- 著作権侵害リスクの確認:
- 既存コンテンツとの類似性チェック:AIが生成したテキストや画像が、既存の著作物と酷似していないかを確認します。特に、インターネット上の膨大なデータを学習しているAIは、意図せず既存の著作物の一部を生成してしまう可能性があります。
- AI生成物の利用規約確認:利用しているAIサービスの利用規約を熟読し、生成されたコンテンツの著作権がどのように扱われるか(ユーザーに帰属するのか、サービス提供者に帰属するのか、共有されるのかなど)を理解します。
- 権利処理の明確化:もしAI生成物が既存の著作物に依拠している可能性がある場合、必要な権利処理(許諾取得、使用料支払いなど)を確実に行うルールを定めます。
著作権法におけるAI生成物の扱いはまだ発展途上であり、国や地域によって解釈が異なる場合があります(出典:文化庁、2024年)。貴社は最新の法規制動向に注意を払い、法務部門と連携して適切なガイドラインを策定すべきです。
- 情報源の明記と責任の所在:
- AIが生成したコンテンツを社外に公開する場合、または重要な意思決定に利用する場合、その情報がAIによって生成されたものであることを明記するルールを検討します。
- 最終的な情報発信や利用に関する責任は、あくまでその情報を承認・利用した人間に帰属することを明確にします。
これらのルールを設けることで、AIの利便性を享受しつつ、誤情報の拡散や法的リスクを回避し、貴社の信頼性を守ることができます。以下に、AI出力物の利用前チェックリストを示します。
| チェック項目 | 確認内容 | 担当者 | 承認 |
|---|---|---|---|
| 事実確認(ファクトチェック) | 出力された情報に誤りがないか、信頼できる情報源と照合したか。 | 利用担当者、専門部署 | 部門責任者 |
| 情報源の確認 | AIが参照したとされる情報源が明確かつ信頼できるか。 | 利用担当者 | – |
| 著作権侵害リスク | 既存の著作物と酷似していないか、利用規約上問題ないか。 | 利用担当者、法務部門 | 法務部門 |
| 個人情報・機密情報 | AI出力物に意図しない個人情報や貴社機密情報が含まれていないか。 | 利用担当者、情報セキュリティ部門 | 情報セキュリティ部門 |
| 倫理的・差別的表現 | 不適切、差別的、または誤解を招く表現が含まれていないか。 | 利用担当者 | 部門責任者 |
| 公開可否判断 | 社外公開に耐えうる品質と正確性があるか。 | 部門責任者、広報部門 | 役員 |
| AI生成物の明示 | (必要に応じて)AIによって生成されたものである旨を明記するか。 | 利用担当者 | 部門責任者 |
プロンプトエンジニアリングの基本原則とベストプラクティス
生成AIを効果的かつ安全に利用するためには、適切な「プロンプトエンジニアリング」の知識が不可欠です。プロンプトエンジニアリングとは、AIから意図した高品質な出力を得るために、AIへの指示(プロンプト)を工夫する技術です。適切なプロンプトは、情報漏洩リスクの低減にも寄与します。
例えば、曖昧なプロンプトはAIに誤った解釈をさせ、意図しない情報(時には機密情報に触れる可能性のある内容)を引き出してしまうリスクがあります。一方で、明確で具体的なプロンプトは、AIの出力をコントロールし、余計な情報の生成を防ぐことができます。
以下の基本原則とベストプラクティスを従業員に教育し、実践を促しましょう。
- 明確性・具体性:
- AIに何をさせたいのか、どのような情報を求めているのかを具体的に記述します。
- 曖昧な表現や専門用語の乱用は避け、誰が読んでも理解できる平易な言葉を使います。
- 例:「会議の要約」ではなく、「〇月〇日の〇〇会議の議事録から、決定事項と次アクションを箇条書きで3点にまとめてください。」
- 文脈の提供:
- AIが適切な回答を生成するために必要な背景情報や前提条件を簡潔に与えます。
- ただし、この文脈に機密情報や個人情報を含めないよう細心の注意を払います。
- 例:「この資料の内容に基づき」と指示する際は、その資料が機密情報を含まない公開資料であるかを確認します。
- 役割の指定:
- AIに特定の役割(例:「マーケティング担当者として」「弁護士として」「カスタマーサポート担当者として」)を与えることで、出力のトーンや視点をコントロールできます。
- これにより、意図しない不適切な表現や、貴社のポリシーに反する出力が生成されるリスクを低減できます。
- 出力形式の指定:
- 箇条書き、表形式、特定の文字数制限など、期待する出力形式を具体的に指定します。
- これにより、AIが余計な情報を付加したり、冗長な表現を使ったりするのを防ぎ、必要な情報のみを効率的に得ることができます。
- 段階的なプロンプト:
- 複雑なタスクは、一度にすべてを指示するのではなく、複数のステップに分けてプロンプトを与えます。
- これにより、各ステップでのAIの出力を確認・修正しながら進めることができ、最終的な出力の品質と正確性を高められます。
- 機密情報を含まない工夫:
- プロンプト自体に機密情報を含めないよう、常に意識します。
- もし機密情報に関する分析が必要な場合は、匿名化・抽象化したデータを用いるか、RAGのように社内データと連携したクローズドなAI環境を利用します。
従業員がプロンプトエンジニアリングのスキルを身につければ、AIをより効率よく使えるようになり、不適切な出力も減らせます。貴社も、社内でのプロンプトエンジニアリングに関する知識共有やベストプラクティス集の作成、トレーニング実施を検討すべきです。
| 良いプロンプトの例 | 悪いプロンプトの例 | 改善点と効果 |
|---|---|---|
| 「あなたは弊社のマーケティング担当者です。競合A社の最新のプレスリリースを分析し、主要な発表内容とその戦略的意図を3つの箇条書きで要約してください。情報源も明記してください。」 | 「A社のプレスリリースについて教えて。」 |
|
| 「以下の顧客アンケート結果(匿名化済み)から、満足度が低いと感じている顧客の共通点を3点、具体的な改善提案と合わせて記述してください。」 | 「アンケート結果を分析して。」 |
|
禁止事項の明確化(ハルシネーションの利用、差別的表現の生成など)
生成AIの利用ルールにおいては、具体的な禁止事項を明確に定めることが、予期せぬトラブルや法的・倫理的リスクを回避するために極めて重要です。従業員が「これはやってはいけない」と認識できるよう、具体的な例を挙げて周知徹底しましょう。
主な禁止事項としては、以下の点が挙げられます。
- ハルシネーション(AIの誤情報生成)の無検証利用:
- AIが生成した情報が事実と異なる、あるいは根拠のない内容であるにもかかわらず、その内容をそのまま利用したり、社外に発信したりすることは厳禁です。
- 前述の通り、AIの出力は必ずファクトチェックを行う義務があり、未検証の情報を鵜呑みにすることは、貴社の信頼失墜に直結します。
- 例えば、AIが生成した架空の統計データや引用元を、あたかも本物であるかのように利用することは、虚偽情報の流布とみなされる可能性があります。
- 差別的・不適切な表現の生成および利用:
- 人種、性別、年齢、国籍、宗教、障がい、性的指向などに基づく差別や偏見を助長する表現。
- 誹謗中傷、名誉毀損、プライバシー侵害にあたる内容。
- 公序良俗に反する、または社会的に不適切とみなされる表現。
- これらの表現をAIに生成させること自体、また生成された内容を業務に利用することは、貴社の企業倫理に反するだけでなく、ハラスメントや法的問題に発展する可能性があります。
- AIは学習データに含まれる偏見を反映することがあり、意図せず差別的な表現を生成するリスクがあるため、出力内容の慎重な確認が求められます。
- AI生成物の「なりすまし」禁止:
- AIが生成したテキスト、画像、音声などを、人間が作成したものであるかのように偽って公開・利用することは原則として禁止すべきです。
- 特に、重要な報告書、論文、アート作品、ニュース記事などでAI生成物を明示せずに利用することは、読者や視聴者に対する欺瞞となり、信頼性を損ないます。
- 一部の国や地域では、AI生成物であることを明示する法規制の検討も進んでおり(出典:経済産業省、2024年)、将来的なリスクを考慮する必要があります。
- 個人情報や機密情報の意図的な入力:
- 「入力情報の制限とガイドライン」で述べた通り、機密情報や個人情報を意図的に、または不注意でAIツールに入力することは厳禁です。
- この禁止事項は、情報漏洩対策の根幹をなすものです。
- 不正競争防止法、著作権法、その他の法令違反:
- AIを利用して、他社の営業秘密を不正に取得したり、著作権を侵害するコンテンツを生成したりすることは固く禁じます。
- AIの利用が関連法令に抵触しないよう、常に法務部門と連携し、最新の情報を把握しておく必要があります。
これらの禁止事項を明確にし、違反した場合の懲戒規定なども含めて社内規程に盛り込むことで、従業員の意識を高め、リスクの高いAI利用を未然に防ぐことができます。
| 禁止事項 | 具体例 | 潜在的リスク |
|---|---|---|
| ハルシネーションの無検証利用 | AIが生成した架空の統計データを報告書に記載する。 | 企業の信頼失墜、誤情報の拡散、法的責任。 |
| 差別的・不適切な表現の生成・利用 | 特定の属性を揶揄する文章をAIに生成させ、社内資料に利用する。 | ハラスメント問題、企業イメージの毀損、法的訴訟。 |
| AI生成物のなりすまし | AIが書いたブログ記事を、人間が書いたかのように公開する。 | 読者の信頼喪失、倫理的問題、将来的な法規制違反。 |
| 機密情報・個人情報の意図的入力 | 未公開の顧客リストをAIにアップロードして分析させる。 | 情報漏洩、個人情報保護法違反、損害賠償請求。 |
| 法令違反となる利用 | AIを利用して他社の著作権物と酷似したデザインを生成し、製品に利用する。 | 著作権侵害訴訟、不正競争防止法違反、ブランド毀損。 |
利用状況の報告義務と責任範囲の明確化
生成AIの利用における情報漏洩やその他の問題が発生した場合に迅速に対応し、再発防止策を講じるためには、利用状況の報告義務と責任範囲を明確にすることが不可欠です。これにより、組織全体としてAI利用のリスクを管理し、継続的な改善サイクルを回すことができます。
- トラブル発生時の報告義務とフロー:
- 報告対象:以下のような事象が発生した場合、速やかに指定された窓口(例:情報セキュリティ部門、AI推進室、総務部)に報告する義務を定めます。
- 誤って機密情報や個人情報をAIに入力してしまった疑いがある場合。
- AIが不適切、差別的、または誤った情報を生成したと判明した場合。
- AIの利用によって、著作権侵害やその他の法的問題が発生した疑いがある場合。
- AIサービスのアカウントが不正アクセスされた疑いがある場合。
- 報告フロー:報告は、口頭だけでなく、書面(専用フォームやメール)でも行うよう義務付け、事象の詳細(日時、AIツール名、入力内容、出力内容、発見者など)を正確に記録する手順を定めます。
- 緊急対応:情報漏洩の可能性がある場合は、直ちにAIツールの利用を停止し、関連データの削除を試みるなど、初動対応に関する指示も明確にします。
迅速な報告は、被害の拡大を防ぎ、法的な対応や顧客への説明責任を果たす上で極めて重要です。ある調査では、情報漏洩発生時の初動対応の遅れが、その後の損害額に大きく影響することが示されています(出典:IBM Security、2023年)。
- 報告対象:以下のような事象が発生した場合、速やかに指定された窓口(例:情報セキュリティ部門、AI推進室、総務部)に報告する義務を定めます。
- 利用者の責任範囲:
- 最終確認義務:AIが生成した情報の最終的な正確性、妥当性、法的・倫理的適合性について確認する責任は、AIを利用した従業員自身に帰属することを明確にします。AIの出力はあくまで「参考情報」であり、最終的な判断は人間が行うべきです。
- ルール遵守義務:貴社が定めたAI利用に関するすべてのルール(利用可能なツール、入力情報の制限、出力情報の確認など)を遵守する義務があります。ルール違反があった場合は、就業規則に基づき懲戒処分の対象となる可能性も明記します。
- 情報セキュリティ意識:常に情報セキュリティへの高い意識を持ち、AI利用に関する最新の情報を自ら学習する姿勢を求めます。
- 管理者・監督者の役割:
- ルールの周知徹底と教育:AI利用に関するルールを従業員に周知し、定期的なトレーニングを実施する責任を負います。
- 利用状況のモニタリングと監査:承認済みのAIツールの利用状況を定期的にモニタリングし、不適切な利用がないかを監査します。必要に応じて、利用ログの確認やヒアリングを行います。
- ルールの見直しと更新:AI技術の進化や法規制の変更に合わせて、AI利用ルールを定期的に見直し、最新の状態に保つ責任を負います。
- インシデント対応:報告されたAI関連のトラブルに対し、適切な調査を行い、再発防止策を講じる責任を負います。
これらの責任範囲を明確にすることで、従業員一人ひとりがAI利用における自身の役割と責任を自覚し、組織全体として安全なAI活用を推進できる基盤が構築されます。私たちも、貴社の組織体制に合わせた責任分担モデルの設計や、インシデント対応計画の策定を支援しています。
| 役割 | 主な責任 | 報告・連携先 |
|---|---|---|
| AI利用者(従業員) |
|
部門責任者、情報セキュリティ部門 |
| 部門責任者 |
|
情報セキュリティ部門、経営層 |
| 情報セキュリティ部門 |
|
経営層、法務部門、各部門責任者 |
| 経営層 |
|
情報セキュリティ部門、法務部門、各部門責任者 |
技術的側面から情報漏洩を防ぐ対策
生成AIの社内利用において、情報漏洩リスクを最小限に抑えるためには、組織的なルール作りと並行して、技術的な側面からの対策が不可欠です。ここでは、貴社が生成AIを安全に活用するための具体的な技術的アプローチをご紹介します。
セキュアな生成AI環境の選定(API連携、プライベートLLM、オンプレミスなど)
生成AIの導入を検討する際、まずどの環境でAIを利用するかが情報漏洩対策の基盤となります。主な選択肢として、外部API連携、プライベートLLM(Retrieval Augmented Generation: RAGを含む)、オンプレミス環境での運用が挙げられます。それぞれの環境には異なるセキュリティ特性とリスクが存在するため、貴社の情報セキュリティ要件と利用目的に合わせて慎重に選定する必要があります。
- 外部API連携: OpenAIのGPTシリーズやGoogleのGeminiなどのSaaS型サービスをAPI経由で利用する形態です。手軽に導入できる反面、送信するデータが外部プロバイダーのサーバーを経由するため、プロバイダーのセキュリティポリシーとデータ利用規約を詳細に確認することが極めて重要です。特に、学習データとして利用されない設定(Opt-out)が提供されているか、データ保持期間はどの程度かなどを確認し、機密情報を直接入力しないようルールを徹底する必要があります。
- プライベートLLM(RAGを含む): 企業が自社データを用いて学習・微調整したLLM、または既存のLLMに自社データベースを連携させて回答精度を高めるRAG(Retrieval Augmented Generation)のような仕組みを指します。これにより、外部に送信する情報を最小限に抑え、情報漏洩リスクを大幅に低減できます。特にRAGは、社内文書やデータベースから関連情報を「検索」し、その情報を基にLLMが回答を「生成」するため、LLM自体に機密情報を学習させることなく、最新かつ正確な社内情報に基づいた回答を得られます。これは機密情報の漏洩リスクを抑えつつ、LLMの有用性を高める有効な手段として注目されています(出典:NVIDIA)。
- オンプレミス環境: 自社のデータセンターやプライベートクラウド上にLLMを構築・運用する形態です。データが社内ネットワークから一切出ないため、最も高いレベルの情報セキュリティを確保できます。ただし、モデルの構築・運用には高度な専門知識と多大なリソース(GPU、ストレージなど)が必要となり、導入・維持コストも高額になる傾向があります。
貴社の情報セキュリティ要件と予算、運用体制を考慮し、最適な環境を選択することが重要です。以下に各環境の比較を示します。
| 環境の種類 | メリット | デメリット | 情報漏洩リスク | コスト・運用負荷 |
|---|---|---|---|---|
| 外部API連携 | 導入が容易、最新モデル利用可能、運用負荷低い | データが外部プロバイダーを経由、カスタマイズ性低い | プロバイダーのセキュリティに依存、情報送信内容の管理が必須 | 比較的安価(従量課金)、運用負荷低い |
| プライベートLLM/RAG | データ制御性が高い、社内情報との連携容易、カスタマイズ可能 | 構築・運用に専門知識が必要、モデル選定・チューニングが複雑 | データは社内管理、モデルへの不正アクセス対策が重要 | 中程度(開発費用、インフラ費用)、運用負荷中程度 |
| オンプレミス | 最高のセキュリティ、完全なデータ制御、高度なカスタマイズ | 構築・運用に高度な専門知識と多大なリソースが必要、コスト高 | データは社内ネットワーク内、物理・論理セキュリティ対策が必須 | 高額(ハードウェア、ソフトウェア、人件費)、運用負荷高い |
データマスキング・匿名化ツールの活用と実装
生成AIに機密情報や個人情報を入力する可能性がある場合、それらの情報をAIモデルが直接認識できないようにする「データマスキング」や「匿名化」は極めて重要な対策です。これにより、万が一AIシステムから情報が漏洩した場合でも、その情報が悪用されるリスクを大幅に低減できます。
- データマスキング: データベースやデータセット内の機密情報を、元のデータとしての構造やフォーマットを保ちつつ、意味のない値や仮の値に置き換える手法です。例えば、顧客の氏名を「A氏」、電話番号を「XXX-XXXX-XXXX」に置き換えるなどです。
- 匿名化: 個人を特定できる情報を完全に削除、または識別できない形に加工する手法です。不可逆的な処理であるため、元の情報に戻すことはできません。統計データ作成などに用いられます。
これらの手法は、AIへの入力データだけでなく、AIが生成した出力データに対しても適用を検討すべきです。例えば、AIが過去の学習データから個人情報に類する情報を出力してしまう「プライバシー侵害」のリスクも指摘されており(出典:国立情報学研究所)、出力内容のフィルタリングも重要になります。
具体的な実装としては、以下のようなツールやアプローチが有効です。
- 特定エンティティ抽出(NER)と置換: 自然言語処理(NLP)技術を用いて、テキスト中の人名、組織名、住所、電話番号などの個人情報や機密情報を自動的に検出し、それを仮のデータや匿名化されたデータに置き換えるツールを導入します。
- データ生成による置換: マスキング後のデータが元のデータの特性(例:郵便番号のフォーマット、クレジットカード番号のチェックサムなど)を維持する必要がある場合、ルールベースや生成AI自身を用いて「似たような意味のないデータ」を生成し、置き換える手法もあります。
- ハッシュ化・暗号化: 特定の識別子に対してハッシュ関数を適用したり、暗号化したりすることで、元の情報を秘匿しつつ、データの一意性を保つことができます。ただし、AIが処理するためには復号が必要になる場合があり、その際のセキュリティも考慮しなければなりません。
データマスキングや匿名化を導入する際は、情報の有用性とセキュリティレベルのバランスを考慮し、貴社の情報セキュリティポリシーに合致した手法を選択することが求められます。以下に主要なマスキング手法とその特徴をまとめます。
| マスキング手法 | 特徴 | 適用シーン | メリット | デメリット |
|---|---|---|---|---|
| 置換(Substitution) | 元のデータを意味のないデータや仮のデータに置き換える | 氏名、住所、電話番号など | 実装が比較的容易、元のデータの形式を維持 | 置換ルールによっては推測されるリスク |
| シャッフル(Shuffling) | 同じデータセット内のデータをランダムに入れ替える | 統計的特性を維持したいデータ(例:給与、年齢) | データの統計的特性を保ちやすい | 元のデータセットから推測される可能性あり |
| 暗号化(Encryption) | データを暗号化し、復号しないと内容がわからないようにする | 高度な機密性が必要なデータ | 高いセキュリティレベル | 処理負荷が高い、鍵管理が必要、AI処理には復号が必要な場合あり |
| トークン化(Tokenization) | 機密データをランダムな非機密値(トークン)に置き換える | クレジットカード番号、社会保障番号など | 機密データとトークンを分離して管理 | トークンと元のデータのマッピング管理が必要 |
| 部分マスキング(Partial Masking) | データの一部のみをマスキングする(例:クレジットカード番号の下4桁以外を非表示) | データの一部を識別できる必要があり、残りを保護したい場合 | 部分的に情報を残せる | マスキングされていない部分からの推測リスク |
アクセス制御と認証強化(多要素認証、SSO連携)
生成AIシステムへのアクセスを厳格に管理することは、情報漏洩対策の基本中の基本です。誰でも自由に機密情報を含むデータをAIに入力したり、AIの管理機能にアクセスしたりできる状態は、極めて危険です。以下の対策を講じることで、不正アクセスによる情報漏洩リスクを大幅に低減できます。
- 最小権限の原則: AIシステムへのアクセス権限は、業務上必要最小限の範囲に限定します。例えば、特定の部署のメンバーのみが機密文書要約AIにアクセスできる、といった形です。職務に応じたロール(役割)を定義し、そのロールに紐づく権限を付与する「ロールベースアクセス制御(RBAC)」を導入することが効果的です。
- 多要素認証(MFA)の導入: パスワードだけでなく、スマートフォンアプリによる認証コード、生体認証(指紋、顔)など、複数の認証要素を組み合わせることで、パスワードの漏洩や推測による不正ログインリスクを大幅に軽減できます。MFAは、世界中で最も効果的なセキュリティ対策の一つとされています(出典:Microsoft)。
- シングルサインオン(SSO)連携: 既存の社内認証システム(Active Directory、Okta、Azure ADなど)と生成AIシステムをSSOで連携させることで、ユーザーは一度の認証で複数のシステムにアクセスできるようになり、利便性を損なわずにセキュリティを強化できます。また、パスワード管理の一元化により、管理負荷の軽減にも繋がります。
- セッション管理の強化: 一度ログインした後のセッション(接続状態)の管理も重要です。一定時間操作がない場合は自動的にログアウトさせる、セッションの有効期間を短く設定する、などの対策により、離席中の不正利用リスクを低減します。
これらのアクセス制御と認証強化策は、AIシステムだけでなく、AIが利用するデータソース(データベース、ファイルサーバーなど)に対しても同様に適用されるべきです。以下に主要な認証強化策とその効果を示します。
| 認証強化策 | 概要 | 情報漏洩対策としての効果 | 導入時の考慮事項 |
|---|---|---|---|
| 多要素認証(MFA) | 2つ以上の異なる要素(知識、所持、生体)を組み合わせて認証 | パスワード漏洩時の不正ログインリスクを大幅低減 | ユーザーの利便性とのバランス、導入コスト、サポート体制 |
| シングルサインオン(SSO) | 一度の認証で複数のシステムにアクセス可能 | パスワード管理の一元化、不正ログイン機会の削減 | 既存認証システムとの連携、サービス停止時の影響 |
| ロールベースアクセス制御(RBAC) | ユーザーの役割(ロール)に基づいてアクセス権限を付与 | 最小権限の原則を徹底、過剰なアクセス権限による情報漏洩防止 | ロール設計の複雑さ、権限管理の負荷 |
| セッション管理の強化 | セッションタイムアウト、再認証要求、セッション固定化対策 | 離席時の不正利用防止、セッションハイジャック対策 | ユーザーの操作中断による不便さ、適切な設定値の決定 |
利用ログの取得と監視体制の構築
生成AIの利用状況を正確に把握し、異常な挙動を早期に検知するためには、詳細な利用ログの取得と、それらを継続的に監視する体制の構築が不可欠です。ログは、万が一情報漏洩が発生した場合の調査や原因究明、再発防止策の立案に不可欠な証拠となります。
- ログ取得の範囲: 以下の項目を網羅的にログとして記録することが推奨されます。
- 誰が(ユーザーID): どのユーザーがAIを利用したか。
- いつ(タイムスタンプ): いつ利用が行われたか。
- 何を(入力プロンプト): どのようなプロンプト(質問や指示)が入力されたか。
- どのように(利用サービス/モデル): どのAIサービスやモデルが利用されたか。
- 生成結果: AIがどのような内容を生成したか(必要に応じて)。
- APIエラーやシステムエラー: システムの異常を示すログ。
特に、入力プロンプトと生成結果のログは、機密情報が含まれていないか、不適切な利用がないかを確認するために重要です。ただし、これらのログ自体が機密情報を含む可能性もあるため、ログの保管方法やアクセス権限も厳重に管理する必要があります。
- ログの保管と分析: 取得したログは、改ざん防止のためセキュアな場所に一定期間保管します。ログ分析ツールを導入し、定期的にレビューすることで、以下のような異常を検知できるようになります。
- 特定のユーザーによる異常に多量のプロンプト入力。
- 不審な時間帯やIPアドレスからのアクセス。
- 機密情報や個人情報に類するキーワードがプロンプトや生成結果に頻繁に出現する。
- 通常業務では考えられないような、特定のトピックに関する問い合わせの集中。
- 監視体制の構築: ログの収集・分析だけでなく、それらを監視し、異常を検知した場合に迅速に対応できる体制を整えることが重要です。
- 担当者の配置: セキュリティ担当者やAI運用担当者が定期的にログをレビューし、不審な活動がないかチェックします。
- アラート設定: 事前に定義したルール(例:特定のキーワードの検知、異常なアクセス頻度など)に基づいて自動的にアラートを発報するシステムを構築します。
- インシデント対応フロー: アラート発生時や情報漏洩の疑いがある場合に、誰が、どのように調査し、どのような手順で対応するのかを明確にしたインシデント対応フローを策定します。
利用ログは、単なる記録ではなく、情報漏洩の予防、早期発見、そして事後対応において極めて重要な役割を果たします。以下にログで監視すべき項目と目的をまとめます。
| 監視項目 | 具体的な内容 | 監視目的 | 情報漏洩対策における意義 |
|---|---|---|---|
| ユーザー活動ログ | ユーザーID、アクセス日時、利用AIモデル、入力プロンプト、生成結果 | 不適切な利用の検知、不正アクセスの追跡 | 内部不正による情報持ち出しの兆候発見、事後調査の証拠 |
| 認証ログ | ログイン試行(成功/失敗)、ログアウト、MFA利用状況 | 不正ログイン試行の検知、アカウント乗っ取りの兆候 | 外部からの不正アクセスによる情報漏洩の防止 |
| APIコールログ | APIリクエスト元IPアドレス、リクエスト内容、レスポンス内容 | APIの不正利用検知、過剰なリクエストによるDDoS攻撃検知 | API経由での情報漏洩やシステム侵害の早期発見 |
| システムエラーログ | システム障害、設定変更、セキュリティ警告 | システムの脆弱性悪用や設定ミスによるリスク検知 | システム障害を装った攻撃や、設定不備による情報漏洩防止 |
| データアクセスログ | AIが参照したデータベースやファイルへのアクセス状況 | AIによる機密データへの不適切なアクセス検知 | AIを介したデータ不正参照による情報漏洩の防止 |
セキュリティパッチの適用と最新情報のキャッチアップ
生成AI技術は日々進化しており、それに伴い新たな脆弱性や脅威も常に生まれています。情報漏洩リスクを継続的に低減するためには、利用しているAIモデル、プラットフォーム、関連ツールに対して、セキュリティパッチを迅速に適用し、常に最新のセキュリティ情報をキャッチアップする体制が不可欠です。
- ベンダーからの情報収集:
- 利用している生成AIモデル(例:OpenAI, Google, Anthropicなど)やプラットフォーム(例:Azure OpenAI Service, AWS Bedrockなど)のベンダーが公開するセキュリティ情報、脆弱性情報、アップデート情報を常に確認します。
- 特に、AIモデルのアップデートには、セキュリティ強化やプライバシー保護に関する改善が含まれていることが多いです。
- セキュリティパッチの迅速な適用:
- ベンダーから提供されるセキュリティパッチやアップデートは、既知の脆弱性を修正し、情報漏洩やサイバー攻撃のリスクを低減するために不可欠です。
- 貴社が利用しているAI環境(オンプレミス、クラウドサービス、API連携など)に応じて、適用手順を確立し、テスト環境での検証を経て、本番環境へ迅速に適用するプロセスを確立します。
- 特に、AI関連のライブラリやフレームワーク(例:TensorFlow, PyTorch)にも脆弱性が見つかることがあるため、これらも定期的に更新する必要があります。
- セキュリティコミュニティとの連携と情報共有:
- 情報セキュリティに関する専門コミュニティや業界団体、政府機関(例:IPA)などが公開するレポートやアラートにも注目し、AI分野特有の新たな脅威や攻撃手法に関する情報を積極的に収集します。
- 自社内でセキュリティチームがある場合は、AI導入部門とセキュリティチームが密接に連携し、情報共有と対策の検討を定期的に行うことが重要です。
- 定期的なセキュリティ診断:
- 導入している生成AIシステムや連携するアプリケーションに対して、脆弱性診断やペネトレーションテストを定期的に実施し、潜在的なセキュリティリスクを洗い出します。
- これにより、自社では気づきにくい脆弱性を発見し、情報漏洩に繋がる前に修正することが可能になります。
生成AIの技術革新は非常に速いため、一度対策を講じたら終わりではありません。継続的な情報収集と対策の実施が、情報漏洩リスクを管理し続けるための鍵となります。以下に、セキュリティパッチ適用と情報キャッチアップのフローを示します。
| ステップ | 内容 | 担当部署 | 目的 |
|---|---|---|---|
| 1. 情報収集 | AIベンダーのセキュリティ情報、脆弱性情報、業界レポート、政府機関のアラートを定期的に確認 | AI運用チーム、セキュリティチーム | 最新の脅威と脆弱性を把握 |
| 2. 影響評価 | 収集した情報が自社のAI環境に与える影響(脆弱性の有無、緊急度)を評価 | セキュリティチーム、AI運用チーム | 対策の優先順位付け |
| 3. パッチ/アップデート計画 | 評価結果に基づき、パッチ適用やシステムアップデートの計画を策定(スケジュール、担当、テスト計画) | AI運用チーム | 安全かつ効率的な対策実施 |
| 4. テスト環境での検証 | 計画に基づき、テスト環境でパッチやアップデートを適用し、機能影響や新たな問題がないか検証 | AI運用チーム、開発チーム | 本番環境への悪影響を防止 |
| 5. 本番環境への適用 | 検証後、本番環境にパッチやアップデートを適用 | AI運用チーム | 脆弱性の解消、セキュリティ強化 |
| 6. 適用後の監視 | 適用後、システムログや監視ツールを用いて、異常がないか継続的に監視 | AI運用チーム、セキュリティチーム | 問題発生時の早期検知と対応 |
従業員への教育と運用体制の確立
生成AIの社内利用を安全かつ効果的に進める上で、技術的な対策だけでなく、従業員一人ひとりの意識と行動が極めて重要です。そのためには、適切な教育と、それを支える運用体制の確立が不可欠となります。ルールを策定するだけでなく、そのルールがなぜ必要なのか、どのように守るべきかを全従業員が理解し、実践できる環境を整えることが、情報漏洩対策の要となります。
全従業員向け研修の実施と定期的な更新
生成AIは進化が速く、利用方法やリスクも常に変化します。そのため、一度ルールを伝えただけで終わりではなく、継続的な教育が必須です。全従業員を対象とした研修を定期的に実施し、最新の情報と貴社の利用方針を共有することが重要です。
- 研修内容の具体例:
- 生成AIの基本知識:メリット、デメリット、ハルシネーション(AIの誤情報生成)のリスク
- 貴社における生成AI利用の基本方針と目的
- 情報漏洩リスク:機密情報、個人情報、顧客情報の入力禁止
- 著作権・知的財産権に関する注意点
- 具体的なNG・OK事例:業務シーンでの具体的な判断基準
- 安全なプロンプトエンジニアリングの基本(機密情報を含まない質問の仕方など)
- 承認済みツール以外の利用禁止
- 研修形式と頻度:
- 導入時研修: 生成AI導入前に全従業員を対象に必須で実施。
- eラーニング: いつでも受講でき、理解度チェックが可能な形式。新入社員向けにも活用。
- 集合研修・ワークショップ: より深い理解と実践的なスキル習得のため、部門別などで実施。
- 定期的な更新研修: 半年に一度、あるいは四半期に一度など、AI技術の進化や貴社のルール改定に合わせて実施。
- 効果測定: 研修後には理解度テストやアンケートを実施し、内容の定着度を確認します。理解が不十分な従業員に対しては、個別フォローや再研修を検討します。
例えば、ある製造業A社では、生成AI導入時に全従業員向けeラーニングを実施し、その後の利用状況や問い合わせ内容を分析して、月1回のオンラインQ&Aセッションで具体的な事例を交えながら補足説明を行っています。これにより、従業員の疑問解消とルールの浸透を促進し、受講率は95%を超え、情報漏洩インシデントは発生していません。
ルールブック・ガイドラインの作成と社内周知徹底
生成AIの利用に関するルールは、誰もがいつでも参照できるよう、明確なルールブックやガイドラインとして文書化し、社内に周知徹底することが不可欠です。これにより、従業員は迷ったときに自ら判断基準を確認でき、一貫した運用が可能になります。
ルールブックには、単なる禁止事項だけでなく、なぜそのルールが必要なのかという背景や、推奨される利用方法なども含めることで、従業員の理解と納得感を深めることができます。また、専門用語を避け、分かりやすい言葉で記述することが重要です。
以下に、ルールブック・ガイドラインに含めるべき主要項目と内容の例を示します。
| 主要項目 | 記載内容の例 | ポイント |
|---|---|---|
| 基本方針と目的 | 生成AIを活用する貴社のビジョン、倫理原則、期待される効果、および情報セキュリティの重要性。 | AI利用の意義と責任を明確にする。 |
| 利用範囲と禁止事項 | 許可される業務範囲(アイデア出し、情報整理、コード生成補助など)、禁止される行為(機密情報・個人情報・顧客情報の入力、差別的表現、ハルシネーションの無断利用など)。 | 具体的なNG・OK事例を多数盛り込む。 |
| 利用ツールの指定 | 貴社が承認し、セキュリティ対策済みの生成AIツールのみ利用可。野良AIや個人契約ツールの利用禁止。 | シャドーIT対策。 |
| 出力内容の取り扱い | 生成AIの出力内容を鵜呑みにせず、必ずファクトチェックを行う。知的財産権、著作権への配慮。社外公開時の承認プロセス。 | 利用者の責任範囲を明確化。 |
| 情報漏洩対策 | プロンプトに機密情報を含めない方法、入力情報の匿名化・抽象化の推奨。利用ログの監視に関する説明。 | 具体的な予防策を提示。 |
| 違反時の対応 | ルール違反が発覚した場合の報告義務、調査プロセス、および懲戒規定との関連。 | ルールの実効性を担保。 |
| 相談窓口 | 疑問や懸念が生じた際の問い合わせ先、連絡方法。 | 従業員の不安解消、適切な利用促進。 |
作成したルールブックは、社内ポータルサイトやイントラネットに掲載し、いつでもアクセスできるようにします。また、新入社員研修での説明や、定期的な全社メールでのリマインドなど、多角的な方法で周知徹底を図り、従業員への浸透度を高めることが重要です。
相談窓口の設置とQ&A集の整備
ルールやガイドラインを整備しても、従業員が「これはどうすればいいのか」「このケースは許可されるのか」といった疑問を抱くことは避けられません。そうした疑問や懸念を解消するために、専門の相談窓口を設置し、迅速かつ正確な情報提供を行う体制を整えることが重要です。
- 相談窓口の役割:
- 従業員からの質問や疑問点の解消
- グレーゾーンの利用判断に関するアドバイス
- ルール違反の報告受付
- 情報漏洩リスクに関する懸念の吸い上げ
- 担当部署と連絡手段:
- IT部門、法務部門、DX推進室、情報セキュリティ部門などが連携して担当。
- メール、社内チャットツール、専用のWebフォームなど、複数の連絡手段を用意し、従業員が気軽に相談できる環境を作る。
- Q&A集の整備:
- 相談窓口に寄せられた質問や、よくある疑問をまとめてQ&A集として公開します。
- 具体的な事例を交え、分かりやすく解説することで、同様の疑問を持つ他の従業員も自己解決できるようになります。
- Q&A集は定期的に更新し、最新の情報やルール改定を反映させます。
相談窓口に寄せられた内容は、単なる個別の回答で終わらせず、匿名化した上で集計・分析し、ルールブックの改善点や研修内容の強化に役立てることで、運用体制全体の質を高めることができます。
違反時の対応と罰則規定の明確化
どんなに厳重なルールを設けても、残念ながら違反が発生する可能性はゼロではありません。万が一の事態に備え、違反時の対応フローと罰則規定を明確にしておくことが、ルールの実効性を保ち、抑止力として機能させる上で不可欠です。
- 罰則規定の明確化:
- 違反のレベル設定: 軽微なミス、不注意による情報漏洩、意図的な情報漏洩など、違反の内容や影響度に応じて段階的なレベルを設定します。
- 段階的な処分: 口頭注意、始末書の提出、生成AIツールの利用一時停止、減給、降格、懲戒解雇など、違反レベルに応じた処分内容を明確にします。
- 就業規則との整合性: 貴社の既存の就業規則や懲戒規定と整合性を保ち、法的な問題が生じないように法務部門と連携して作成します。
- 対応フローの確立:
- 違反の検知と報告: ログ監視システムや内部通報などにより違反を検知した場合の報告経路を明確にします。
- 事実確認と調査: 迅速かつ公平に事実関係を調査し、関係者からのヒアリングや証拠収集を行います。
- 処分決定: 調査結果に基づき、人事部門や法務部門と連携して適切な処分を決定します。
- 再発防止策: 当該従業員への指導、全体への注意喚起、ルールの見直しなど、再発防止に向けた具体的な措置を講じます。
罰則規定は、従業員に過度な萎縮を与えるものではなく、あくまで情報セキュリティの重要性を認識させ、責任ある行動を促すためのものであるべきです。例えば、あるサービス業B社では、生成AI利用ログの定期的な監視により、機密情報に類似するキーワードがプロンプトに入力されかけた事例を早期に発見し、インシデントに発展する前に当該従業員への指導とルールの再周知を行うことで、実害を未然に防ぎました(出典:情報セキュリティ白書2023)。
定期的な監査とルールの見直しプロセス
生成AI技術は日進月歩で進化しており、それに伴い新たな利用方法やリスクも登場します。一度確立したルールや運用体制も、時間の経過とともに陳腐化する可能性があるため、定期的な監査と見直しプロセスを組み込むことが不可欠です。
- 監査内容:
- 利用ログの監視: 承認済みAIツールの利用ログを定期的に確認し、不審な操作や機密情報の入力履歴がないかをチェックします。
- ルール遵守状況の確認: 各部門におけるルール遵守状況をヒアリングやアンケートを通じて確認します。
- 出力内容のサンプリングレビュー: 生成AIの出力内容の一部を抽出し、情報漏洩リスクやハルシネーションの有無をレビューします。
- 従業員ヒアリング: 実際の利用状況や課題、改善提案などを従業員から直接聞き取ります。
- ルールの見直しプロセス:
- 定期的なレビュー会議: IT部門、法務部門、人事部門、各事業部門の代表者などで構成されるレビュー委員会を設置し、四半期ごとや半期ごとに定期的に会議を開催します。
- インプット情報の活用: 監査結果、相談窓口に寄せられた事例、最新のAI技術動向、業界のベストプラクティスなどをインプット情報として活用します。
- ルール改訂と周知: 必要に応じてルールブックやガイドラインを改訂し、全従業員に速やかに周知します。改訂理由や変更点を明確に伝えることが重要です。
例えば、ある金融機関C社では、四半期ごとに「AI利用ルールレビュー委員会」を開催し、利用状況の分析、新たなAIツールの評価、規制動向の確認を徹底しています。これにより、市場の変化に迅速に対応し、常に最新のセキュリティレベルを維持したまま生成AIを安全に活用できています(出典:金融庁「金融分野における生成AI利用に関する原則」)。このような継続的な取り組みこそが、貴社の情報資産を守り、生成AIの恩恵を最大限に享受するための鍵となります。
Aurant Technologiesが支援する生成AI安全活用ソリューション(独自見解)
生成AIの社内利用は、業務効率化や新たな価値創造の大きな可能性を秘めている一方で、情報漏洩リスクや倫理的な課題といった懸念を払拭しきれない企業も少なくありません。私たちは、貴社が生成AIを安全かつ効果的に活用できるよう、包括的なコンサルティングと技術支援を提供しています。単なるツールの導入に留まらず、貴社の事業特性や組織文化に合わせた最適なソリューションを提案し、持続可能なAI活用体制の構築をサポートします。
貴社に最適なAI導入コンサルティングとリスクアセスメント
生成AIの導入を成功させる第一歩は、現状の業務プロセスと潜在的なリスクを正確に理解することです。私たちが提供するAI導入コンサルティングでは、まず貴社のビジネス目標、既存システム、データ環境、そして従業員のAIリテラシーレベルを詳細にヒアリングし、現状を徹底的に分析します。その上で、生成AIを導入することでどのような業務が効率化され、どのような新しい価値が生まれるか、具体的なユースケースを特定します。
同時に、最も重要となるのがリスクアセスメントです。情報漏洩、ハルシネーション(AIの誤情報生成)、著作権侵害、バイアス、個人情報保護といった多岐にわたるリスク要因を洗い出し、それぞれの発生確率と影響度を評価します。この評価に基づき、貴社独自の利用ガイドラインやポリシー策定を支援し、法的・倫理的側面からのリスクを最小限に抑えるための具体策を立案します。例えば、特定業界の規制(金融、医療など)に準拠したデータ取り扱い方法や、機密情報のマスキング・匿名化プロセスの導入など、貴社のニーズに合わせたオーダーメイドのアプローチを提案します。
セキュアなデータ連携・活用基盤構築(kintone連携、BIツール連携など)
生成AIを社内で安全に活用するためには、既存の業務システムやデータソースとのセキュアな連携基盤が不可欠です。私たちは、貴社がすでに利用しているkintone、Salesforce、各種BIツールなどのデータと生成AIを安全に連携させるための技術支援を行います。特に、機密情報を含む社内データを外部のAIモデルに直接入力するリスクを回避するため、RAG(Retrieval Augmented Generation:検索拡張生成)アーキテクチャの導入を強く推奨しています。
RAGは、社内データベースから関連情報を検索し、その情報を基にAIが回答を生成する仕組みです。これにより、AIモデル自体に機密情報を学習させることなく、最新かつ正確な社内情報に基づいた回答を得ることが可能になります。私たちは、貴社のデータソースに応じたRAGシステムの設計・構築、API連携のセキュリティ強化、アクセス制御、そしてデータ匿名化・秘匿化技術の導入をサポートします。これにより、従業員は安心して生成AIを活用し、業務効率を大幅に向上させることができます。
例えば、既存の品質管理データベースと連携するRAGシステムを構築すれば、過去の不良事例や改善策をAIが即座に参照でき、現場からの問い合わせに素早く答えられるようになります。
業務プロセスへのAI組み込み支援とDX推進
生成AIの真価は、単体での利用に留まらず、既存の業務プロセスに深く組み込むことで発揮されます。私たちは、貴社の具体的な業務課題をヒアリングし、生成AIを活用した最適なソリューションを提案します。例えば、契約書レビューの自動化、顧客対応チャットボットの導入、マーケティングコンテンツの自動生成、データ分析レポートの要約など、多岐にわたるユースケースにおいてPoC(概念実証)から本格導入までを支援します。
当社のコンサルティングでは、AI導入による業務フローの再設計、既存システムとのシームレスな連携、そして効果測定指標(KPI)の設定を行います。導入後も、継続的な効果検証と改善提案を通じて、貴社のDX(デジタルトランスフォーメーション)を強力に推進します。AI導入によって得られる具体的な成果としては、例えば、資料作成時間の平均25%短縮、カスタマーサポートの一次対応率向上、営業リードの質向上などが挙げられます。私たちは、単なるツール提供者ではなく、貴社のビジネスパートナーとして、AIを活用した持続的な成長を支援します。
従業員向けAIリテラシー向上トレーニングとルール浸透支援
どんなに優れたAIツールやルールを導入しても、それを活用する従業員のリテラシーが追いつかなければ、効果は半減し、かえってリスクを高める可能性があります。私たちは、貴社の従業員が生成AIを安全かつ効果的に使いこなせるよう、実践的なトレーニングプログラムを提供します。トレーニング内容は、AIの基本的な仕組みや機能、プロンプトエンジニアリングの基礎から応用、そして最も重要な情報漏洩リスクや著作権、倫理的な利用に関する教育まで多岐にわたります。
特に、「情報漏洩対策」については、具体的な事例を交えながら、どのような情報が機密情報に当たるのか、外部AIサービスに入力してはならない情報の種類、そして万が一漏洩してしまった場合の対応策などを徹底的に教育します。また、策定した利用ルールが単なる「お触れ書き」で終わらないよう、従業員がルールを理解し、日常業務で自然に実践できるような浸透支援も行います。定期的なワークショップ開催や、疑問点を解消できるサポート体制の構築を通じて、組織全体のAIリテラシー向上とルールの定着を促します。
以下は、私たちが推奨する従業員向けAIセキュリティ対策トレーニングの主要項目です。
| 項目 | 主な内容 | 目的 |
|---|---|---|
| AIの基本とリスク理解 | 生成AIの仕組み、ハルシネーション、バイアス、情報漏洩リスクの基礎知識 | AI利用の前提となる知識と潜在リスクの認識 |
| プロンプトエンジニアリング | 効果的な指示の出し方、機密情報を避けるプロンプト作成、出力評価のコツ | AIを最大限に活用しつつ、安全性を確保 |
| 情報セキュリティとプライバシー | 社内機密情報・個人情報の定義、外部AIサービスへの入力禁止事項、データ匿名化の重要性 | 情報漏洩リスクの回避と法的・倫理的遵守 |
| 著作権と倫理的利用 | 生成AI出力物の著作権、他者の著作権侵害リスク、AI生成物の開示義務 | 法規制遵守と企業倫理の徹底 |
| 緊急時対応と報告体制 | 情報漏洩や不適切なAI利用が発覚した場合の報告手順、対応フロー | インシデント発生時の迅速かつ適切な対応 |
継続的な運用サポートとリスクマネジメント体制構築
生成AIの技術は日々進化しており、それに伴いリスクの性質も変化していきます。私たちは、AI導入後の貴社が持続的に安全かつ効果的にAIを活用できるよう、継続的な運用サポートとリスクマネジメント体制の構築を支援します。具体的には、AI利用状況のモニタリング、利用ログの分析、新たなリスク要因の特定、そしてそれに対応するための利用ガイドラインやポリシーの定期的な見直しを行います。
また、最新のAI技術動向や各国の規制動向を常にキャッチアップし、貴社に最適な情報を提供します。万が一、情報漏洩などのインシデントが発生した際には、迅速な原因究明と対応策の立案、再発防止策の実施までを一貫してサポートします。貴社のAI活用が常に最先端で、かつ安全な状態を保てるよう、私たちは長期的なパートナーシップを築き、貴社のビジネスを支援し続けます。
まとめ:生成AIの可能性を最大限に引き出すために
生成AIは、単なる流行ではなく、貴社のビジネスモデルや競争環境を根本から変革しうる強力なツールです。しかし、その可能性を最大限に引き出し、同時に情報漏洩リスクを最小限に抑えるためには、戦略的かつ継続的なアプローチが不可欠となります。
変化に対応し、柔軟なルール運用を
生成AI技術の進化は目覚ましく、日々新しいモデルや機能が登場しています。今日最適とされたルールが、明日には時代遅れになる可能性も否定できません。このような状況下で、一度策定したルールをそのまま放置することは、かえって貴社のイノベーションを阻害したり、シャドーIT(非公式なツールの利用)を生む原因となりかねません。
貴社が生成AIの恩恵を最大限に享受するためには、ルールを定期的に見直し、常に最新の技術動向、法規制、そして社内での利用実態に合わせて柔軟に更新していく姿勢が求められます。例えば、AI生成コンテンツに対する識別表示の義務化など、国内外で新たな規制の動きも出てきています(出典:我国出台新规,要求 AI 生成合成内容必须添加标识,落实难度如何?)。このような外部環境の変化にも迅速に対応できるよう、見直しサイクルを明確に設定し、従業員からのフィードバックを積極的に取り入れることが重要です。
以下に、生成AI利用ルールを見直す際に考慮すべき主要なチェックポイントをまとめました。
| チェック項目 | 確認内容 | 考慮すべき観点 |
|---|---|---|
| 技術動向の変化 | 新しい生成AIモデルや機能がリリースされていないか。 | 例:マルチモーダルAI(GPT-4oなど)の登場、RAG(Retrieval Augmented Generation)による社内データ連携の高度化。 |
| 法規制・ガイドラインの変更 | 国内外のAI関連法規、政府・業界団体のガイドラインが更新されていないか。 | 例:各国のAI規制動向、個人情報保護法、著作権法の解釈、AI生成コンテンツの表示義務。 |
| 社内利用実態の分析 | 従業員が生成AIをどのように利用しているか、新たなユースケースは生まれているか。 | 利用ログ分析、アンケート、ヒアリングを通じて実態を把握し、ルールの実効性を評価。 |
| リスクの再評価 | 過去に発生したインシデントや、新たなリスク要因が浮上していないか。 | 情報漏洩リスク、ハルシネーションによる誤情報拡散リスク、倫理的リスク、プロンプトインジェクション対策。 |
| 従業員からのフィードバック | ルールに対する意見や改善提案が寄せられていないか。 | ルールが実務に即しているか、使いやすさに問題はないか、シャドーITの兆候はないか。 |
| セキュリティ対策の強化 | 新たな脅威に対応するためのセキュリティ機能(DLP、CASBなど)の導入・強化の必要性。 | プロンプトフィルタリング、出力内容の監視、アクセス制御の最適化。 |
専門家との連携で安全なAI活用を推進
生成AIの導入と運用は、単なるITツールの導入に留まらず、法務、情報セキュリティ、ITインフラ、業務改革、そして組織文化といった多岐にわたる専門知識と経験を必要とします。多くの企業にとって、これら全ての領域を社内リソースだけでカバーすることは非常に困難です。
そこで、外部の専門家との連携が重要になります。専門家は、客観的な視点から貴社の現状を評価し、最新の業界動向やベストプラクティスに基づいた具体的なアドバイスを提供できます。これにより、貴社はより安全かつ効率的に生成AIを導入・運用し、情報漏洩リスクを最小限に抑えながら、その可能性を最大限に引き出すことが可能になります。
専門家が提供できる支援内容は多岐にわたりますが、代表的なものとしては以下のような点が挙げられます。
- リスク評価とアセスメント: 貴社の事業内容、データ特性、既存のセキュリティ体制に基づいた、情報漏洩リスク、ハルシネーションリスク、著作権リスクなどの包括的な評価。
- ルール策定・改定支援: 各国の法規制(例:GDPR、CCPA、国内の個人情報保護法)や業界ガイドラインに準拠しつつ、貴社の実態に即した実効性のある利用ガイドラインの策定および継続的な改定サポート。
- 技術導入・運用支援: セキュアなAI環境(例:データ隔離が可能なクラウドAIサービス、オンプレミス型LLM)の構築支援、既存のセキュリティツール(DLP、CASBなど)との連携、RAG(Retrieval Augmented Generation)システムを用いた社内情報活用の最適化。
- 従業員研修: 情報セキュリティに関する意識向上教育、効果的なプロンプトエンジニアリングのベストプラクティス、倫理的・コンプライアンスに準拠したAI利用に関する実践的な研修プログラムの提供。
- 継続的なモニタリング・監査体制構築支援: AI利用状況の可視化、異常検知メカニズムの構築、定期的なセキュリティ監査の実施支援。
生成AIは、貴社の業務効率を劇的に向上させ、新たな顧客体験を創造し、マーケティング戦略を革新する可能性を秘めています。この変革の波に乗り遅れることなく、貴社の競争力を強化するためには、適切なルールと、信頼できる外部専門家のサポートが不可欠です。
私たちAurant Technologiesのような専門家は、貴社が生成AIの力を最大限に活用し、同時に潜在的なリスクを適切に管理できるよう、実践的な知見と経験を提供することで、貴社のAI活用を強力に後押しいたします。未来志向の貴社がAI時代を勝ち抜くためのパートナーとして、ぜひお声がけください。
安全な活用を支える「データ入力判別」の実務チェックリスト
ルールを策定しても、現場の従業員が「どのデータなら入力して良いか」を瞬時に判断するのは困難です。情報漏洩を未然に防ぐため、以下の判断基準を社内ガイドラインに組み込むことを推奨します。
- 機密性の確認: その情報は、万が一競合他社や一般に公開された場合、自社の不利益(経済的損失や信頼失墜)につながりませんか?
- 個人情報の有無: 特定の個人を識別できる情報(氏名、メールアドレス、電話番号等)が含まれていませんか?
- 権利関係の確認: そのデータは自社が権利を保有している、または入力が許可されているものですか?(他社の著作物や預かり資産ではないか)
- 加工の余地: 固有名詞を「A社」「商品B」などの一般名詞に置き換えても、目的とする回答が得られませんか?
判断に迷う場合は「入力しない」を原則とし、必要に応じて情報システム部門や法務部門へ相談するフローを徹底してください。また、データ基盤と連携した高度な活用を検討される場合は、SFA・CRM・MA・Webの違いとデータ連携の全体設計を理解しておくことで、どの領域にAIを組み込むべきかの判断が容易になります。
商用版(API利用)と無料版チャットツールの決定的な違い
多くの企業が「ChatGPT Enterprise」や「Azure OpenAI Service」といった商用環境を導入する最大の理由は、入力データの取り扱いにあります。一般向けの無料版や一部の安価なプランとは異なり、エンタープライズ向けサービスでは「入力したプロンプトをモデルの学習に利用しない」ことが規約で保証されています。
| 比較項目 | 一般向け無料版・個人版 | 法人向け商用版(API/Enterprise) |
|---|---|---|
| データの学習利用 | 原則として学習に利用される(設定でオフも可だが限定的) | 一切学習に利用されない(規約で明記) |
| セキュリティ管理 | 個人単位の管理 | SSO連携、監査ログ、IP制限などの一括管理が可能 |
| データ保存場所 | プロバイダーの規定に準ずる | Azure等の指定リージョンを選択可能な場合が多い |
| SLA(稼働保証) | 基本的になし | あり(稼働率99.9%など) |
公式ドキュメントと最新のセキュリティリファレンス
技術的な安全性を担保するためには、AIプロバイダーが公開している公式のセキュリティホワイトペーパーを常に参照してください。以下は主要な一次情報源です。
- OpenAI Trust Center:セキュリティ、プライバシー、コンプライアンスに関する最新情報
- Azure OpenAI Service のデータ、プライバシー、セキュリティ:Microsoftによるデータ保護の仕組み
- 内閣府 AI戦略会議資料:日本国内におけるAI利用のガイドライン・規制動向
また、AIをマーケティングや顧客接点に活用する際は、データの流れを可視化することが重要です。BigQueryとリバースETLを用いたアーキテクチャを参考に、セキュアなデータ基盤からAIを駆動させる構成も検討に値します。
📚 関連資料
このトピックについて、より詳しく学びたい方は以下の無料資料をご参照ください:
生成AIの法人導入・セキュリティ設計のご相談
ChatGPTやClaudeなど生成AIのプラン選定・セキュアな全社導入・権限/ログ設計を、貴社の体制に合わせて整理します。すでに導入済みの環境について『この設計で問題ないか』を確認したい、という導入前後のセカンドオピニオンにも対応しています。
本ピラーで深掘りすべき関連実装記事
本ガイドのテーマと関連性の高い実装ノウハウ記事をご紹介します。
- 【企業向け】ChatGPTビジネス導入・活用戦略:法人プラン徹底比較からDX成功事例、リスク対策まで
- 通話分析AIで顧客の声を見える化し、売上向上・業務効率化を実現。導入の基本から選び方、成功の秘訣まで
- RPA導入で失敗しない実務ガイド|業務選定・PoC・保守設計の進め方
- 【実践ガイド】CRMで顧客データを一元管理!BtoB企業の売上を最大化する導入・活用術
- 【実践ロードマップ】BtoB企業のデータドリブン経営:KPI設計から成功への全ステップ
- 顧客満足度調査(CSAT・NPS)でビジネスを加速!設計・分析・活用・DX連携の実践ガイド
- Snowflake活用完全ガイド:データ分析でビジネスを加速させる始め方と成功の秘訣
- データで顧客体験(CX)を最適化!企業成長を加速させる実践的データ活用戦略
- 「AIがすごい」だけでは終わらない!Salesforce×kintone連携で運用設計が全てを決める
- 【失敗しないSalesforce導入】業務設計とデータ連携でDXを加速する実践戦略
- kintone導入で「業務効率化が進まらない」と悩む企業へ:3つの落とし穴と実践的解決策
- BtoB企業のLINE公式アカウント成功戦略:運用から効果測定、DX連携まで徹底解説
- 【決裁者・担当者向け】LLMを業務に活かす!導入から成果までの完全ロードマップ
- ChatGPTで業務効率化を最大化!部門別活用事例と実践プロンプト集【決裁者・担当者必見】
- kintone連携でCRMは劇的に変わる。失敗しないための全戦略と実践
- AIチャットボット 顧客対応自動化ガイド 2026
- 【企業向け】LINE公式アカウントチャットボットで顧客対応を自動化・効率化する実践ガイド
- LINE運用担当者必見!成果を最大化するコンテンツ作成とターゲティングの極意
- 生成AIが拓くコンテンツマーケティングの新時代:SEO記事・SNS投稿の実践戦略
- Aurant Technologiesが伝授!RPA導入で失敗しない選定とスコープ設計の進め方
- データガバナンス導入完全ガイド:課題克服からツール選定まで、DXを加速する実践ステップ
- 企業のDXを加速!AIコードエージェント(Devin, Cursor, Windsurf)徹底比較と導入・活用戦略
- “更新されないSFA”を終わらせる:AIが自動更新し、人は承認だけにする設計
- データ分析DXを加速!CursorでSQL/Pythonコードを高速生成・最適化し、生産性とROIを最大化する実践戦略
- ゼロトラストで実現するクラウド業務の認証・アクセス制御設計:DX時代のセキュリティ基盤構築ガイド
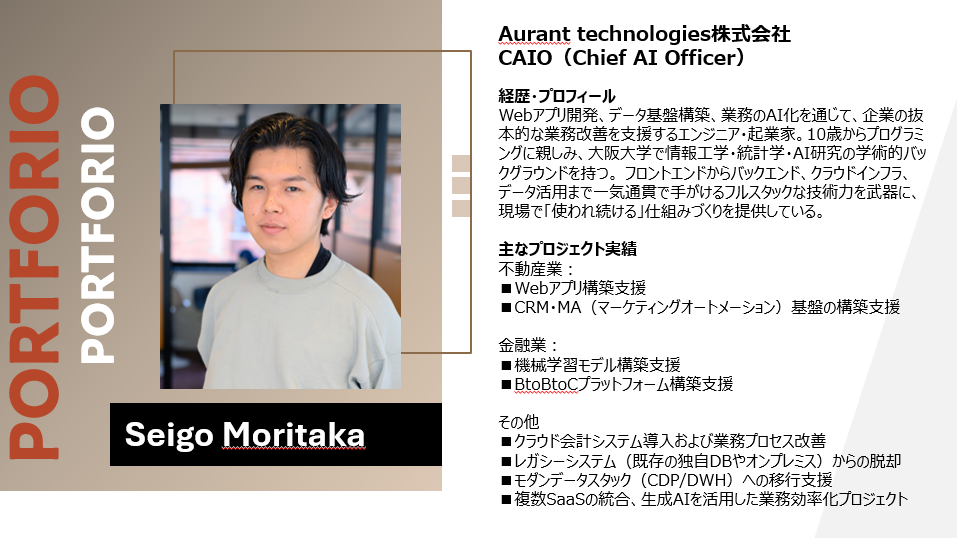
本記事の執筆・監修
Aurant Technologies 株式会社 / CAIO (Chief AI Officer)
AI活用支援
Claude・ChatGPT・Gemini・Copilotのどれをどの業務に使うかの見極めから、社内のAIチャット環境、権限と情報の扱いの設計、MCPやAPIでの既存システム連携、研修・伴走までを支援します。