CDP を入れる前に顧客データの名寄せを試す|確かなキーから順につなぎ、つなぎ間違いの疑いを拾う
会員・通販の注文・LINE の友だち・店舗の会員カードを、会員 ID・メール・電話の順に1つずつ足してつなぎ、足すたびに何が変わるかを数える進め方です。統合率は分母の数え方で大きく変わり、上げるほど良い数字ではありません。共有されている値を外す決まりと、正解の無い自社データでつなぎ間違いの疑いを拾う方法を、図と BigQuery の SQL で示します。
目次 クリックで開く
CDP の提案では、会員と通販の注文、LINE の友だち、店舗の会員カードをつなげば、1人のお客さんが見えると説明されます。では、自社のデータは何割がつながり、別人を1人にまとめてしまうことはどれくらいあるのでしょうか。
この記事では、手元のデータを確かなキーから順につなぎ、キーを1つ足すたびに何が変わるかを数える進め方と、つなぎ間違いの疑いを拾う方法を書きます。先に結論を言うと、統合率は上げるほど良い数字ではありません。CDP を検討している通販・小売のマーケティング担当と、情報システム担当に向けた内容です。
当社は顧客データの統合・分析の基盤づくりを支援しています。データと図は説明のために当社が作ったもので、会社・人物・数字は架空です。
CDP に渡す前に、手元のデータでキーを1つずつ足して数える
CDP の名寄せは、いくつかのデータの記録を、共通のキーで1人にまとめる仕組みです。Treasure Data の CDP では、この仕組みを ID Unification と呼びます。Salesforce Data 360(旧 Data Cloud)では「ID 解決」です。どちらも、どのキーでつなぐかは使う側が設定します。この記事では、まとまった1人に振る ID を統合 ID と呼びます。
見積の前に知りたいのは、自社のデータがどのキーでどれだけつながり、どこで別人をまとめてしまうかです。そこで CDP に渡す前に、手元のデータでキーを1つずつ足し、そのたびに数えます。足していくのは次の6つの段階です。
- 会員 ID だけ
- +メール(そのまま):大文字と小文字も区別し、まったく同じ値だけでつなぐ
- +メール(正規化):表記をそろえてからつなぐ
- +電話(正規化)
- +氏名と郵便番号:カナと郵便番号、漢字と郵便番号の組み合わせでつなぐ
- 共有されている値を外す:ここまでのキーから、家族などで共有されているメール・電話の値を外す
キーは、会員 ID のように1人に1つで変わりにくいものから足しました。Treasure Data のドキュメントも、更新で統合 ID が変わるのを抑えるために、変わらないキーを設定の先頭に置くよう勧めています。ここで1つずつ足すのは、キーごとの効き方を確かめるためです。
段階ごとに数えるのは2つです。1つは「正しくつながった人」で、別人の入っていない統合 ID の中で、2つ以上のデータの記録がつながった人を指します。もう1つは「つなぎ間違いの ID」で、別人が入ってしまった統合 ID の数です。
4つのデータが、どのキーを持っているかを一覧にする
最初に、つなぐデータと、それぞれが持つキーを表にします。ここでは会員、通販の注文、LINE の友だち、店舗の会員カードの4つです。1行のデータを、ここでは記録と呼びます。
| データ | 会員 ID | メール | 電話 | 氏名(漢字) | 氏名(カナ) | 郵便番号 | 生年月日 |
|---|---|---|---|---|---|---|---|
| 会員 | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 通販の注文 | ログインした注文だけ | ○ | ○ | ○ | — | ○ | — |
| LINE の友だち | アカウント連携した人だけ | アンケートで回答した人だけ | — | — | — | — | — |
| 店舗の会員カード | 登録したカードだけ | — | ○ | — | ○ | ○ | — |
表にすると、データごとの手がかりの偏りが見えます。店舗の会員カードにはメールが無く、会員 ID を登録したカードを除けば、電話かカナと郵便番号でしかつながりません。注文にはカナが無いので、氏名でつなぐなら漢字です。生年月日は会員の記録にしかありません。
LINE の友だちの記録が持つのは、アカウント連携した人の会員 ID と、アンケートで回答した人のメールだけです。LINE プラットフォームは、LINE のユーザーと自社サービスのユーザーをひも付ける仕組みそのものは提供していません。ひも付けは、アカウント連携などで自社側が実装する必要があります(公式の Tips)。LINE・メール・会員 ID の名寄せは、別の記事でも扱っています。
データを集める前に、利用目的も確かめます。個人情報保護委員会の Q&A(7-2)では、同じ会社の中での個人データの提供は第三者提供に当たらないとしています。ただし、当初の利用目的を超えて使うなら、本人の同意が要ります。本人が合理的に予測できないような分析をするなら、分析することを含めて利用目的を特定する、という Q&A(2-1)もあります。例に挙がっているのは、購買履歴などを分析して、好みに合わせた広告を出す場合です。グループ会社の間でのやり取りは、委託や共同利用などに当たる場合を除き、ガイドラインで第三者提供とされる事例です。4つのデータの利用目的を、個人情報の担当と先に見ておきます。
電話を足したところで、正しくつながった人もつなぎ間違いもいちばん増える
ここからの数字は、説明用に作った2万人分のデータ(4つのデータの記録が合わせて57,684件)での値です。このデータには、どの記録が本当は同じ人かの正解を持たせてあるので、正しくつながった人とつなぎ間違いの ID を数えられます。自社のデータでは数えられないので、代わりに見るものを後で書きます。
まず、まったく同じ値でつなげば安全、とは言えません。メールをそのままつないだ段階で、251の統合 ID に別人が入りました。どれも、家族が同じメールを使っていた組です。
メールは、表記をそろえる正規化(Salesforce のヘルプでは「標準化」)をしてからつなぎます。Treasure Data の ID Unification は値の完全一致でつなぎ、表記ゆれは自動では直しません。先にそろえる必要があるとドキュメントにあります。Salesforce の照合方法「完全 (標準化)」は、メールの大文字と小文字、前後の空白をそろえます。gmail.com のアドレスからは、ピリオドと「+」の文字を消します。この記事では、大文字と小文字・空白・全角と半角をそろえ、Gmail では「+」以降の付け足しまで消しました。
正規化すると、統合 ID は2,064減りましたが、正しくつながった人は210人しか増えていません。測る前は、ゲスト購入の注文がつながる分で、もっと増えると見込んでいました。正規化の効きは、新しい人がつながるより、同じ人の残りの記録がまとまるほうに出ました。
電話も正規化してから足します。Salesforce の「完全 (標準化)」は、空白と記号を消し、国コードか国名が分かるときはそれを使って E164 形式にします。分からないときは、国コードなしでそろえます。この記事では、0 で始まる国内の書き方も +81 で始まる書き方も、+81 で始まる形にそろえました。
電話を足した段階で、正しくつながった人は691人増え、つなぎ間違いの ID は309から784に増えました。会員 ID を登録していない店舗の会員カードは、この段階では電話でしかほかのデータとつながらないからです。間違いのほうは、家の固定電話と、店頭で入れた仮の電話番号から来ています。1つの統合 ID の記録数の最大は17件から88件に跳ね、仮の番号では1つの ID に69人がまとまりました。
1人のお客さんで見ると、メールの正規化と電話で、次のようにつながります。
会員 ID だけで、LINE の友だち・会員・ログインした注文がまとまります。ゲスト購入の注文は、メールのピリオドの有無で会員と値が違い、正規化して初めてつながりました。店舗の会員カードにはメールが無く、電話を足した段階でつながっています。電話は3通りの書き方で入っていますが、正規化すると同じ値になります。
氏名と郵便番号を足すと、正しくつながった人はかえって133人減りました。記録数の最大も、88件から206件に膨らんでいます。氏名と郵便番号の一致が、仮の番号でできた ID に、さらに記録を集めたためです。最後の段階の結果は、共有されている値の外し方と一緒に後で見ます。
統合率は、元の件数に何を数えるかで大きく変わる
Salesforce のヘルプでは、統合率を「1 – (統合個人数 / ソース個人数)」で出します。100件の記録が80人にまとまれば20%です。手元のデータでも、同じ式で数えられます。Salesforce の用語のヘルプには、一致ルールを足すと統合率が上がり、ルールの中の一致条件を足すと統合率が下がる、ともあります。
つまり統合率は、つなぐ範囲の広さで動く数字です。そのうえ、元の件数に何を入れるかでも、率は大きく動きます。注文の記録を1件ずつ数えると、同じ会員の注文が1人にまとまるだけで率が上がるからです。
会員 ID だけでつないだ段階で、記録をすべて数えると38.4%、注文を除いた3つで数えると8.6%でした。会員 ID だけでつないだときの率の大半は、同じ会員の注文がまとまった分です。CDP の画面や提案で統合率を見たら、注文ごとの購入者を1件ずつのプロファイルとして取り込んでいるかを聞きます。統合率だけで名寄せの出来を比べず、記録数の最大や、疑いの条件に当たった ID の数のように、自社のデータでも数えられるものと並べて見ます。
共有されている値を外すと、統合率は下がり、正しくつながった人は増える
共有されている値には、公式の資料にも注意があります。Salesforce のヘルプは、一意の外部識別子を除き、電話番号やメールだけのように1つの連絡先で一致させることは避けるよう勧めています。世帯のメンバーと共有の連絡先が、1つの統合プロファイルにまとまりうるからです。ヘルプの手当ては、名前やメールなどの一致条件を足して、ルールを狭める方向です。
Treasure Data のドキュメントは、氏名、共有のメールやメーリングリスト、家の電話番号をキーに使わないよう書いています。個人にひも付いた携帯電話の番号は、使えるキーに挙がっています。空の値や「N/A」のような値は、設定でキーから外せます。会員 ID のような一意のキーの値が違う記録を、ほかのキーが同じでもつながない設定(do_not_merge_key)もあります。
この記事では、条件を足す代わりに、共有されている値そのものをキーから外しました。正規化したメールと電話の値ごとに、付いている氏名と生年月日の種類を数え、次のどちらかに当たる値を外します。氏名2種類までを許したのは、結婚で姓が変わった本人がありうるからです。
- 別の氏名(カナか漢字)が3種類以上付いている
- 生年月日が2種類以上付いている
外れたのは、メールの値40と電話の値143で、電話のうち118は生年月日で外れました。店頭で入れた仮の番号は、すべて外れています。
外すと、4つのデータの記録をすべて数えた統合率は59.9%から59.2%に下がりました。それでも、正しくつながった人は11,178人から11,553人に増え、6つの段階でいちばん多くなっています。つなぎ間違いから抜けた人は539人です。2つ以上のデータのつながりを失った人は12人で、12人とも、外す前は別人の入った ID でつながっていました。新しくつなぎ間違いに入った人はいません。1つの統合 ID に入った別人の最大は、72人から3人になりました。
一方で、つなぎ間違いの ID は780から615へ、2割ほどしか減りませんでした。測る前は半分以下になると見込んでいましたが、外れです。残ったのは、おもに家族2人で使うメールと家の固定電話でした。氏名が2種類まで、生年月日が1種類まで(付いていない値も含む)の値は、どちらの決まりにも掛かりません。生年月日は会員の記録にしか無いので、2人とも会員でない世帯の値には生年月日が付かず、残ります。2種類で外す決まりは試していませんが、結婚で姓が変わった本人の値まで外れるおそれがあります。
氏名と郵便番号のキーには、注意が要ります。Treasure Data のドキュメントは氏名をキーにしないよう書いており、このデータでも足した段階で正しくつながった人が減りました。Salesforce の個人の一致ルールのヘルプでは、名前は単独のキーではなく、メールや電話、住所と組み合わせる一致条件として出てきます。使うなら最後の段階に回します。外す決まりはメールと電話の値にしか掛からないので、別世帯の同姓同名でつながった値は残ります。
正解の無い自社データでは、氏名が2種類以上ある統合 ID を候補として人が見る
自社のデータには、誰が本当は同じ人かの正解がありません。そこで、統合 ID ごとに次の3つの疑いの条件を当て、説明用のデータの正解と照らしました。
- 氏名が2種類以上(正規化したカナか漢字)
- 生年月日が2種類以上
- 記録数が上位1%
先に断ると、このデータには氏名と生年月日の入力ゆれ(ひらがなと全角カナ、旧字体、誤字)を入れていないので、次の結果はどれもその前提での値です。
氏名が2種類以上の ID は632あり、うち558に本当に別人が入っていました。つなぎ間違い615のうち91%を、この条件だけで拾えています。外れた74は、どれも結婚で姓が変わった1人の ID でした。
生年月日が2種類以上の ID は141で、すべて別人でしたが、拾えたのは23%です。生年月日を持つのが会員の記録だけで、2人とも会員でないと条件に当たらないからです。記録数が上位1%の ID(記録9件以上)は236あり、本当に別人だったのは35%でした。残りの153は、注文の多い常連1人の ID です。
測る前は、氏名の条件は結婚で姓が変わった人を拾い、外れが多いと見込んでいました。結果は、3つの中で氏名の条件がいちばん多く拾えています。実際のデータでは、表記ゆれのせいで氏名の条件の外れが増えることがあります。だから氏名は先に正規化してから数え、拾った ID は、別人かどうかを人が見る候補として扱います。
どの条件にも当たらなかったつなぎ間違いも、54ありました。うち30は、別人の記録が LINE の友だちだけで、氏名も生年月日も持っていません。21は、片方がカナしか無い店舗の会員カード、もう片方が漢字しか無い注文で、氏名を比べられない組み合わせでした。LINE の記録で入った別人は、統合 ID の中を見ても見分けられません。だから LINE は、アカウント連携で会員 ID とのひも付けを増やす側で直します。
条件を値ではなく統合 ID の単位で当てるのは、値の決まりをすり抜けたものを拾うためです。たとえば、家の固定電話で同じ世帯の2人がまとまった ID があります。固定電話の値に付いた生年月日は会員の1件だけなので、値ごとの決まりでは外れません。ID の中を見れば生年月日が2種類あり、条件に当たります。
記録数の最大も、自社のデータで毎回数えられます。電話を足した段階で最大が跳ねたのが、その例です。Salesforce のヘルプでは、1つの統合プロファイルに入るソースプロファイルは最大50,000件です。通常、大きなプロファイルはデータ品質が低いか、一致ルールが広すぎることが原因だ、と補足があります。
Treasure Data の Tips は、統合 ID ごとに付いたキーの値の数を、分布で見る方法を示しています。値が1つだけの ID が多いと、識別子どうしのつながりが足りないことがある、という書き方です。短い利用で値が1つしか無い人が多い、という別の理由も挙げています。
CDP の見積の前に、自社で決めたことを1枚の表にする
ここまでで決めたことを表にすると、次のようになります。右の列は、それぞれの製品の資料で、近い役割の設定です。
| 決めること | 手元のデータで決めた中身 | CDP の資料にある、近い役割の設定 |
|---|---|---|
| キーと順番 | 会員 ID → メール → 電話。家族2人で使う固定電話は外す決まりでは残るので、携帯と固定を分けられるなら固定はキーにしない。氏名と郵便番号は、使うなら最後に(同姓同名は外す決まりでも残る) | Treasure Data:merge_by_keys の並び(先が優先。変わらないキーを先頭に)、家の電話はキーにしない/Salesforce:一致ルールと一致条件 |
| 表記のそろえ方 | メールの大文字・空白・全角と半角、Gmail のピリオドと「+」以降、電話の +81 の形、郵便番号の7桁 | Treasure Data:自動ではそろえない(先に自分で)/Salesforce:照合方法「完全 (標準化)」 |
| 外す値 | 別の氏名が3種類以上か、生年月日が2種類以上付いたメール・電話の値。店頭の仮の番号 | Treasure Data:invalid_texts・valid_regexp/Salesforce:1つの連絡先だけで一致させず、一致条件を足す |
| 確かめ方 | 氏名を正規化してから、氏名が2種類以上の統合 ID を人が見る。記録数の最大を毎回見る | Treasure Data:統合 ID ごとのキーの値の数の分布(result_key_stats)/Salesforce:統合率と、1つの統合プロファイルのソースの上限 |
左の2列は、どの CDP を選んでも自社で決めておくものです。右の列の設定で、それをそのまま書けるかを、見積の打ち合わせで確かめます。つなぐ計算と、データが増えたときのつなぎ直しは、CDP に任せる部分です。
そのまま使える SQL と、数字の出し方・試していないこと
名寄せ・統合率・疑いの条件の数は、BigQuery(東京リージョン)で、ここに載せる SQL を説明用のデータに実行して数えました。正しくつながった人、つなぎ間違いの ID、1つの ID に入った別人の数、疑いの条件で本当に別人だった割合などは、正解と照らした数です。これらは、正解の表と照らす別の SQL で数えています(載せていません)。
載せるのは実行した版で、表名を一般の名前に置き換え、コメントを1行足して1語直したほかは、そのままです。各ファイルの冒頭の説明と、最後に件数を返す文(外した値の数や繰り返しの回数を見る文)は省き、途中で省いた所は「(略)」の行で示しました。SQL のコメントにある「段」と stage 列の番号は6つの段階の順番で、「ダミー」は店頭で入れた仮の電話番号のことです。
1本目は、4つのデータを1行1記録に並べ直し、キーの表記をそろえます。説明用のデータでは Gmail の代わりに別のドメインを同じ扱いにしたので、そのドメインが dot_domains に入っています。使うときは消してください。
-- メール:全角→半角(NFKC)、空白と引用符・角括弧を取る、小文字にする
CREATE TEMP FUNCTION clean_email(e STRING) AS (
  LOWER(REGEXP_REPLACE(NORMALIZE(e, NFKC), r'[\s"\'<>]', ''))
);
-- メール:形がメールでなければ NULL。gmail 風のドメインだけ、ローカル部の「+」以降とピリオドを取る
CREATE TEMP FUNCTION norm_email(e STRING, dot_domains ARRAY<STRING>) AS (
  CASE
    WHEN NOT REGEXP_CONTAINS(clean_email(e), r'^[^@]+@[^@]+\.[a-z]+$') THEN NULL
    WHEN SPLIT(clean_email(e), '@')[OFFSET(1)] IN UNNEST(dot_domains) THEN
      CONCAT(REPLACE(REGEXP_REPLACE(SPLIT(clean_email(e), '@')[OFFSET(0)], r'\+.*$', ''), '.', ''),
             '@', SPLIT(clean_email(e), '@')[OFFSET(1)])
    ELSE clean_email(e)
  END
);
-- 電話:全角→半角、数字と「+」だけ残す。0 始まり(国内)と +81 始まりを、どちらも +81… の E.164 形式にそろえる
--   ここでは形をそろえるだけで、000-0000-0000 のようなダミーの判定はしない(段6で扱う)
CREATE TEMP FUNCTION norm_phone(p STRING) AS ((
  SELECT IF(REGEXP_CONTAINS(e164, r'^\+81[0-9]{9,10}$'), e164, NULL)
  FROM (SELECT CASE
          WHEN STARTS_WITH(d, '+81') THEN CONCAT('+81', LTRIM(SUBSTR(d, 4), '0'))
          WHEN STARTS_WITH(d, '0')   THEN CONCAT('+81', SUBSTR(d, 2))
        END AS e164
        FROM (SELECT REGEXP_REPLACE(NORMALIZE(p, NFKC), r'[^0-9+]', '') AS d))
));
-- 氏名(漢字・カナ):全角→半角の統一(半角カナは全角カナになる)と、姓と名の間の空白(半角・全角)を取る
CREATE TEMP FUNCTION norm_name(n STRING) AS (
  NULLIF(REGEXP_REPLACE(NORMALIZE(n, NFKC), r'\s', ''), '')
);
-- 郵便番号:数字だけ残し、7桁でなければ NULL(「〒」・ハイフン・全角を吸収)
CREATE TEMP FUNCTION norm_postal(z STRING) AS (
  (SELECT IF(LENGTH(d) = 7, d, NULL) FROM (SELECT REGEXP_REPLACE(NORMALIZE(z, NFKC), r'[^0-9]', '') AS d))
);
-- (略) CREATE OR REPLACE TABLE `your_project.your_dataset.cdp_records` … AS
WITH src AS (
  SELECT 'members' AS source, member_id AS src_id, member_id, email, phone, name, name_kana, postal_code, birth_date, registered_at AS event_date
  FROM `your_project.your_dataset.cdp_members`
  UNION ALL
  SELECT 'orders', order_id, member_id, email, phone, name, NULL, postal_code, NULL, order_date
  FROM `your_project.your_dataset.cdp_orders`
  UNION ALL
  SELECT 'line', line_uid, member_id, email, NULL, NULL, NULL, NULL, NULL, friend_added
  FROM `your_project.your_dataset.cdp_line`
  UNION ALL
  SELECT 'store', card_no, member_id, NULL, phone, NULL, name_kana, postal_code, NULL, issued_at
  FROM `your_project.your_dataset.cdp_store`
)
SELECT
  CONCAT(UPPER(SUBSTR(source, 1, 1)), ':', src_id) AS rec_id,   -- データの頭文字+元の ID(M:/O:/L:/S:)
  source, src_id, member_id,
  email AS email_raw,                                      -- 段2で「生の値のまま」つなぐために残す
  -- 'example.com' は、説明用のデータで Gmail の代わりに使ったドメイン。実務では消し、ピリオドと「+」以降を同じ宛先として扱うドメインだけを並べる
  norm_email(email, ['gmail.com', 'googlemail.com', 'example.com']) AS email_norm,
  norm_phone(phone) AS phone_norm,
  norm_name(name) AS name_norm,
  norm_name(name_kana) AS kana_norm,
  norm_postal(postal_code) AS postal_norm,
  birth_date, event_date
FROM src;
2本目は、6つの段階ごとに、記録とキーの対応を縦に並べた表を作ります。6つめの段階で、共有されている値を外します。
-- (略) CREATE OR REPLACE TABLE `your_project.your_dataset.cdp_keys` … AS
WITH r AS (SELECT * FROM `your_project.your_dataset.cdp_records`),
-- 記録ごとのキーの候補(種類ごとに1行)
k AS (
  SELECT rec_id, 'member_id' AS key_type, member_id AS key_value FROM r WHERE member_id IS NOT NULL
  UNION ALL SELECT rec_id, 'email_raw',   email_raw  FROM r WHERE email_raw IS NOT NULL
  UNION ALL SELECT rec_id, 'email_norm',  email_norm FROM r WHERE email_norm IS NOT NULL
  UNION ALL SELECT rec_id, 'phone_norm',  phone_norm FROM r WHERE phone_norm IS NOT NULL
  UNION ALL SELECT rec_id, 'kana_postal', CONCAT(kana_norm, '|', postal_norm) FROM r WHERE kana_norm IS NOT NULL AND postal_norm IS NOT NULL
  UNION ALL SELECT rec_id, 'kanji_postal', CONCAT(name_norm, '|', postal_norm) FROM r WHERE name_norm IS NOT NULL AND postal_norm IS NOT NULL
),
-- 段6のため:メール・電話の値ごとに、別の氏名・別の生年月日がいくつ付いているか
shared AS (
  SELECT key_type, key_value,
    COUNT(DISTINCT r.kana_norm) AS n_kana, COUNT(DISTINCT r.name_norm) AS n_kanji, COUNT(DISTINCT r.birth_date) AS n_birth
  FROM k JOIN r USING (rec_id)
  WHERE key_type IN ('email_norm', 'phone_norm')
  GROUP BY key_type, key_value
),
-- 段と、その段で使うキーの種類
ladder AS (
  SELECT * FROM UNNEST([
    STRUCT(1 AS stage, ['member_id'] AS key_types),
    STRUCT(2, ['member_id', 'email_raw']),
    STRUCT(3, ['member_id', 'email_norm']),
    STRUCT(4, ['member_id', 'email_norm', 'phone_norm']),
    STRUCT(5, ['member_id', 'email_norm', 'phone_norm', 'kana_postal', 'kanji_postal']),
    STRUCT(6, ['member_id', 'email_norm', 'phone_norm', 'kana_postal', 'kanji_postal'])
  ])
)
SELECT ladder.stage, k.rec_id, CONCAT(k.key_type, ':', k.key_value) AS key, k.key_type
FROM ladder
CROSS JOIN UNNEST(ladder.key_types) AS t
JOIN k ON k.key_type = t
LEFT JOIN shared USING (key_type, key_value)
WHERE NOT (ladder.stage = 6 AND IFNULL(shared.n_kana >= 3 OR shared.n_kanji >= 3 OR shared.n_birth >= 2, FALSE));
3本目が名寄せです。A と B が同じキーを持ち、B と C がまた別のキーで一致すれば、A・B・C を1人とみなします。記録ごとに番号を持たせ、キーでつながる記録どうしで小さいほうの番号にそろえることを、変わる記録が無くなるまで繰り返します。
DECLARE changed INT64 DEFAULT 1;
DECLARE iter INT64 DEFAULT 0;

-- 記録に番号を振る(rec_id の順。番号の最小=rec_id の最小)
CREATE TEMP TABLE recs AS
SELECT rec_id, ROW_NUMBER() OVER (ORDER BY rec_id) AS rec_no FROM `your_project.your_dataset.cdp_records`;
-- 段ごとの「記録番号とキーのハッシュ」
CREATE TEMP TABLE kk AS
SELECT k.stage, r.rec_no, FARM_FINGERPRINT(k.key) AS key_h
FROM `your_project.your_dataset.cdp_keys` k JOIN recs r USING (rec_id);

-- 1. すべての段 × すべての記録に、自分の番号をラベルとして置く
CREATE TEMP TABLE lab AS
SELECT s AS stage, rec_no, rec_no AS label, rec_no AS old_label
FROM recs, UNNEST(GENERATE_ARRAY(1, 6)) AS s;

WHILE changed > 0 AND iter < 50 DO
  SET iter = iter + 1;
  CREATE OR REPLACE TEMP TABLE lab AS
  WITH key_min AS (          -- 2. キーごとのラベルの最小値
    SELECT kk.stage, kk.key_h, MIN(l.label) AS min_label
    FROM kk JOIN lab l USING (stage, rec_no)
    GROUP BY kk.stage, kk.key_h
  ),
  step AS (                  -- 3. 自分のラベルと、持っているキーの最小値のうち小さいほう
    SELECT l.stage, l.rec_no, l.label AS old_label,
      LEAST(l.label, IFNULL(MIN(km.min_label), l.label)) AS label
    FROM lab l
    LEFT JOIN kk USING (stage, rec_no)
    LEFT JOIN key_min km ON km.stage = kk.stage AND km.key_h = kk.key_h
    GROUP BY l.stage, l.rec_no, l.label
  )
  SELECT a.stage, a.rec_no, LEAST(a.label, b.label) AS label, a.old_label   -- 近道:ラベルの記録のラベルも見る
  FROM step a JOIN step b ON b.stage = a.stage AND b.rec_no = a.label;
  -- 4. 置き換わった記録の数
  SET changed = (SELECT COUNTIF(label != old_label) FROM lab);
END WHILE;

-- (略) CREATE OR REPLACE TABLE `your_project.your_dataset.cdp_unified` … AS
SELECT l.stage, r.rec_id, u.rec_id AS unified_id
FROM lab l JOIN recs r ON r.rec_no = l.rec_no JOIN recs u ON u.rec_no = l.label;
説明用のデータでは、6つの段階とも6回の繰り返しで、変わる記録が0になりました。Treasure Data のドキュメントでも、更新された記録の数が0になることを、つなぎ終わったかの目安にしています。
4本目は、2通りの分母の統合率です。あわせて、同じキーが2つ以上の統合 ID に分かれていないかも数えます(0 なら、つなぐ計算に抜けがありません)。
WITH u AS (
  SELECT u.stage, u.rec_id, u.unified_id, r.source
  FROM `your_project.your_dataset.cdp_unified` u JOIN `your_project.your_dataset.cdp_records` r USING (rec_id)
),
rate AS (
  SELECT stage,
    COUNT(*) AS records,
    COUNT(DISTINCT unified_id) AS unified_ids,
    ROUND(1 - COUNT(DISTINCT unified_id) / COUNT(*), 4) AS rate_all_rows,
    COUNTIF(source != 'orders') AS records_no_orders,
    COUNT(DISTINCT IF(source != 'orders', unified_id, NULL)) AS unified_ids_no_orders,
    ROUND(1 - COUNT(DISTINCT IF(source != 'orders', unified_id, NULL)) / COUNTIF(source != 'orders'), 4) AS rate_no_orders
  FROM u GROUP BY stage
),
size AS (   -- 1つの統合 ID にまとまった記録の数の、最大と上位1%の境目
  SELECT stage, MAX(n) AS max_records_per_id, APPROX_QUANTILES(n, 100)[OFFSET(99)] AS p99_records_per_id
  FROM (SELECT stage, unified_id, COUNT(*) AS n FROM u GROUP BY stage, unified_id)
  GROUP BY stage
),
closure AS (   -- 1つのキーが2つ以上の統合 ID にまたがっていないか(0 であるべき)
  SELECT stage, COUNTIF(n_ids > 1) AS keys_split_check
  FROM (SELECT k.stage, k.key, COUNT(DISTINCT u.unified_id) AS n_ids
        FROM `your_project.your_dataset.cdp_keys` k JOIN `your_project.your_dataset.cdp_unified` u USING (stage, rec_id)
        GROUP BY k.stage, k.key)
  GROUP BY stage
)
SELECT * FROM rate JOIN size USING (stage) LEFT JOIN closure USING (stage)
ORDER BY stage;
5本目は、統合 ID ごとに3つの疑いの条件を当てます。SQL の flag_a〜flag_c が、氏名・生年月日・記録数の条件です。条件に当たった ID は、氏名の条件から順に記録を並べて人が見ます。
-- (略) CREATE OR REPLACE TABLE `your_project.your_dataset.cdp_suspects` … AS
WITH per_id AS (
  SELECT u.stage, u.unified_id, COUNT(*) AS n_records,
    COUNT(DISTINCT r.kana_norm) AS n_kana, COUNT(DISTINCT r.name_norm) AS n_kanji, COUNT(DISTINCT r.birth_date) AS n_birth
  FROM `your_project.your_dataset.cdp_unified` u JOIN `your_project.your_dataset.cdp_records` r USING (rec_id)
  GROUP BY u.stage, u.unified_id
),
ranked AS (
  SELECT *,
    ROW_NUMBER() OVER (PARTITION BY stage ORDER BY n_records DESC, unified_id) AS size_rank,
    COUNT(*) OVER (PARTITION BY stage) AS ids_in_stage
  FROM per_id
)
SELECT stage, unified_id, n_records, n_kana, n_kanji, n_birth,
  (n_kana >= 2 OR n_kanji >= 2) AS flag_a_names,
  n_birth >= 2 AS flag_b_birth,
  size_rank <= CEIL(ids_in_stage * 0.01) AS flag_c_top1pct
FROM ranked;
名寄せの1回で約230 MB を処理し、課金は290 MB でした。このスクリプトでは、実行前の見積(ドライラン)が0バイトと出ました。BigQuery の公式のドキュメントでは、表を作る文のドライランは最初の1つを確かめたところで止まり、一時表を作る文はドライランに対応していません。WHILE の文では、その場で止まります。課金の上限(maximumBytesBilled)を付けて実行します。
試していないこともあります。Salesforce の「あいまい」の照合方法のような、似た値をつなぐ方法は試していません。一致条件を足す組み方、会員 ID が違う記録をつながない設定、氏名と郵便番号を抜いて外す決まりだけを足した比べ方も、していません。携帯と固定の電話を分けてつなぐ比べ方、住所の番地、カナと漢字の読みの突き合わせもしていません。実在の CDP に同じデータを入れた突き合わせ、毎日の追加分だけをつなぐ更新、数百万件の規模での処理時間も確かめていません。
見積の打ち合わせの前にやること
- 4つのデータのキーの表を作る
- 6つの段階でつなぎ、段階ごとに2通りの統合率と記録数の最大を数える
- 疑いの条件に当たった統合 ID を人が見る
- 決めたことの表を持って、CDP の設定でそのまま書けるかを聞く
自社のデータでこの数え方を回し、CDP に渡す前の決まりを作るところは、当社のデータ分析の支援で一緒に進められます。
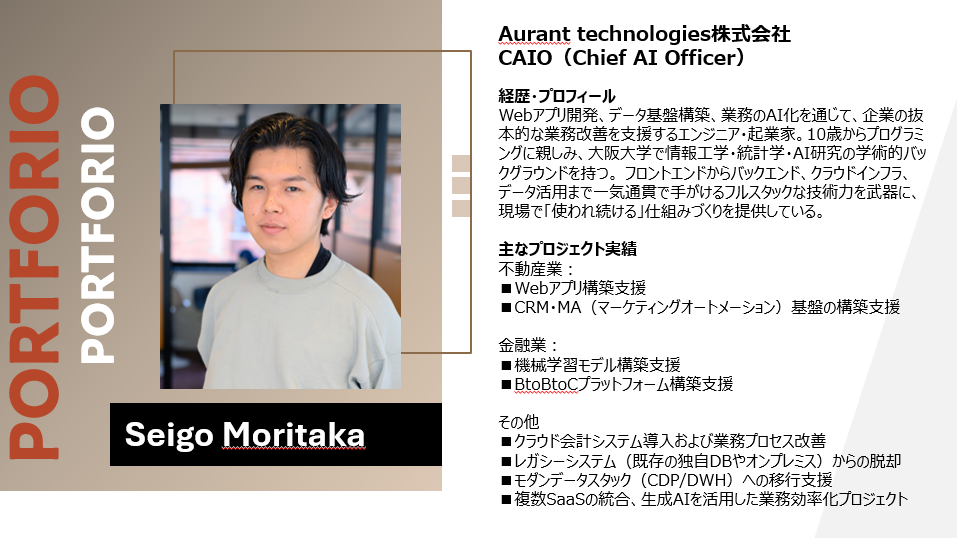
執筆・監修
Aurant Technologies CAIO(Chief AI Officer)
Webアプリ開発とデータ基盤の構築、CRM・MA基盤の構築支援を手がける。本記事は、Treasure Data と Salesforce の公式ドキュメント、LINE Developers、個人情報保護委員会の該当ページを確認して執筆しています。
アクセス解析・マーケティングデータ支援
GA4とGTMのタグ設計から、フォーム送信・電話タップ・資料DLといったコンバージョンの計測整備、Looker Studioでのダッシュボード化までを一貫して支援します。